随机计算:6 个晶体管如何实现 32 位浮点乘法运算
首发于公众号「如是有为」 · 查看原文
八千对六:最离谱的计算差距
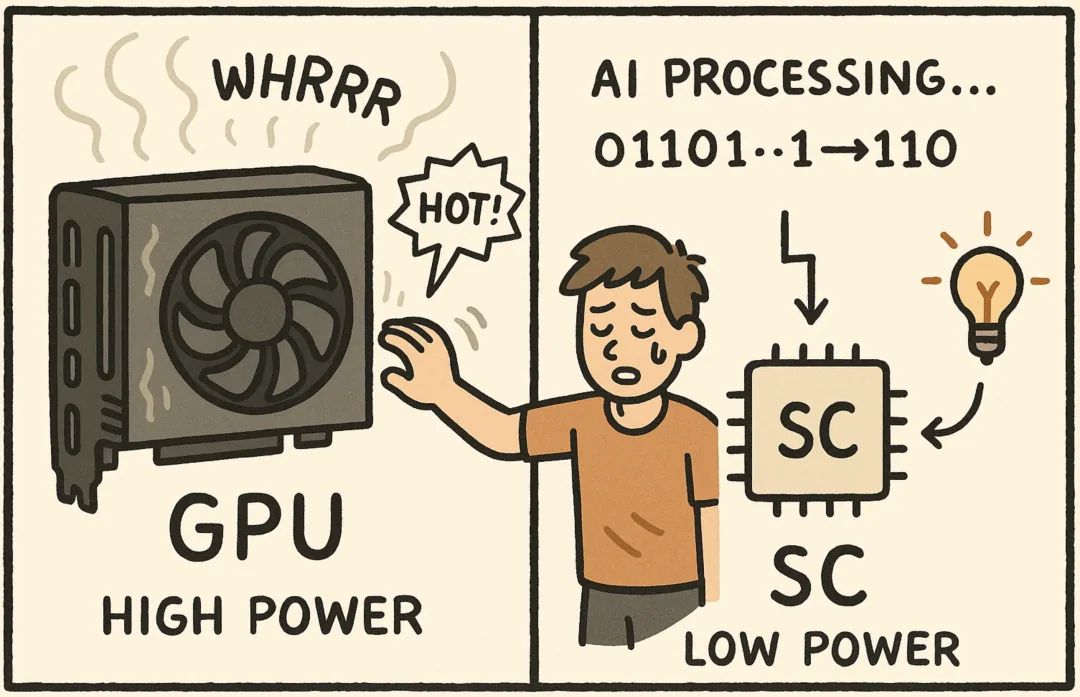
在硬件的世界里,有些数字会让人当场愣住。一个 32 位浮点乘法器,需要大约八千个晶体管;而在随机计算(Stochastic Computing,简称 SC)里,只要一个最普通的 AND 门,六个晶体管,就能算出同样的乘法结果。八千对六,这种荒谬的比例一摆出来,就像是让人同时看见了两个时代:一个时代是钢铁轰鸣的庞大工厂,一个时代是简陋小屋里一个孩子掷骰子。
为什么要这么在意?因为现代 AI 模型最烧的,就是乘法。每一层卷积,每一组矩阵相乘,背后都是海量的乘法器在发热。每多一个晶体管,就是更大的面积、更高的成本、更夸张的能耗。于是 GPU 的世界里,几万个乘法器并排,几百瓦功率往外烧。而如果六个小小的 MOS 管就能干掉一个完整的浮点乘法器,那整个游戏规则都得改写。
一根比特流:骰子抖出一个数
随机计算的秘诀,在于它把数值重新定义了。
我们习惯的二进制,是死板的:0.75 就必须写成一串精确的位,32 位也好,64 位也好,一位不差。而随机计算说,不用这么麻烦。0.75 是什么意思?就是有百分之七十五的几率为一,百分之二十五的几率为零。那我就给你一根比特流,里面大约四分之三是 1,四分之一是 0,这根流就是 0.75。
你看这串:
1011010110111010...
如果你数得足够长,就会发现“1”的比例稳定在 75% 左右。于是数值变成了概率,变成了密度。它不是硬性写死的位宽,而是可以用时间去换精度:你看得越久,就越精确;你看得越短,就越模糊。
这就是随机计算的第一层魔法:一个比特流,就能表示任意精度的数值。
6个管子干掉8000管子:逻辑门的算术魔法
真正让人拍案的是,当这些比特流流进最普通的逻辑门时,居然能自己“算出”加减乘除。
拿 AND 门说事儿。假设一根流代表 0.6,另一根代表 0.8。你把它们同时送进 AND 门,只有当两边同时是 1 时,输出才是 1。
于是输出流里,“1”的比例正好是 0.6×0.8 = 0.48。这就是乘法。再看看电路图,最经典的 CMOS AND,上面两只 PMOS 并联,下面四只 NMOS 串联。六个晶体管,一拍一抖,完成了原本需要八千个晶体管才能搞定的 32 位浮点乘法。
加法也能用门电路“抖”出来。最简单的组合是 OR 减去 AND,输出的概率就逼近了两个输入的和。虽然不完美,但在很多场景下已经够用。如果想更精细,就让 MUX 出手,用一根第三的比特流控制选择,最后得到的就是概率意义上的加权和。别看只是一颗小小的选择器,实际上它就是一个概率加权器。
NOT 门更直白,输入流有多少概率是 1,输出就有多少概率是 0。XOR 门则算的是差异度,当两股流不同时才输出 1,转化成概率,就是 pA(1−pB)+(1−pA)pB。
连 AI 里最经典的非线性激活函数 Sigmoid,都能用多项式逼近后拼出来。在 [-2,2] 的区间里,Sigmoid 可以写成 0.5 + x/4 - x^3/48。常数 0.5 用固定流表示,x/4 让 MUX 稀释输入,x^3 让 AND 门连三次再稀释。几颗门电路拼起来,就画出了那条平滑的 S 型曲线。
这时候你会明白,在随机计算的世界里,逻辑门不再只是对错裁判,而是算术工人。它们不停翻转,不停抖动,最后把统计意义上的结果抖了出来。
工厂对骰子:GPU 和 SC 的两种哲学
讲完了怎么算,再回头看 GPU,差别才真正显眼。
GPU 是工厂。每一颗乘法器都要用掉上千晶体管,数万台机器并排运转,输入一样,输出必须永远一模一样,精确到小数点后若干位,差一位都不行。它是一条流水线,机器轰鸣,钢铁秩序,消耗海量电力来换取绝对的确定性。
随机计算是骰子。一个小小的 AND 门,每一拍的结果可能不同,但只要你抛得足够多,概率分布一定会稳定。它不在乎“每一次都准”,它在乎“多数情况下对”。
工厂和骰子,这就是两种哲学。前者是数字计算的骄傲,后者是概率计算的疯子。而 AI 的本质是什么?是统计,是容错,是在噪声中找规律。换句话说,骰子的逻辑,反而更贴近 AI 的灵魂。
冷门实验室的疯子候选
问题来了:既然听起来这么神奇,为什么我们没在手机、服务器里见过这种随机计算芯片?
原因是很现实的——它现在并不热门。
这个想法其实在上世纪六十年代就被提出来过,那时浮点电路太贵,研究者希望用便宜的逻辑门拼出算术。后来摩尔定律让浮点单元越来越便宜,随机计算就被抛在一边,变成论文角落里的奇思妙想。
直到 AI 的兴起,人们才又把它翻出来。因为深度学习天生带着概率性,推理时只要“多数正确”就够了,训练时本来就靠随机梯度。随机计算的逻辑突然对上了。
但就算如此,它也依然是冷门。今天的研究多停留在实验室原型。有人在 FPGA 上跑过小规模的神经网络,用随机流算卷积,证明可行;有人在北京大学提出过“随机计算加残差修正”的加速器,用少量额外逻辑来兜住误差;有人甚至直接用 ReRAM、MRAM 这些器件的物理噪声生成随机流,试图把计算和存储揉在一块。
这些实验说明它能跑,但距离大规模产业化还有很长的路。现在它更多像一个边缘的疯子候选,不主流,不热门,却足够有趣,足够让人遐想。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。