开源 RISC-V 最尴尬的地方:大系统不敢用,小芯片反而敢用? 编码器芯片为什么一般不用MCU?
首发于公众号「如是有为」 · 查看原文
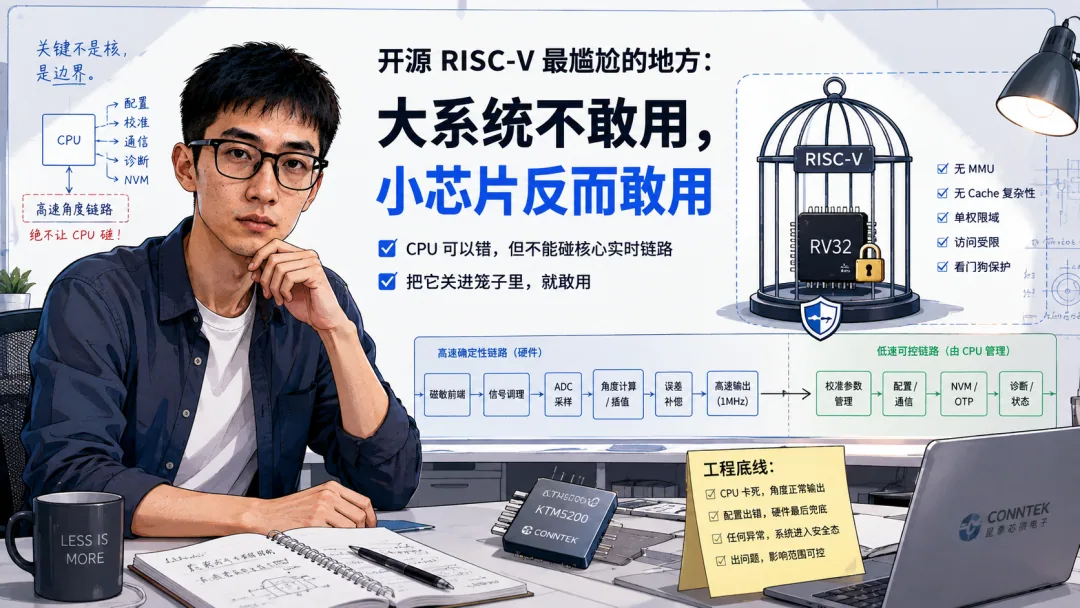
最近在看芯片里的小 CPU,有个问题一直挺扎眼。
现在开源 RISC-V 核已经很多了。
Ibex、CV32E40P,RTL 能看,验证环境能看,有些甚至连 formal proof 都公开了。
按道理,这应该是芯片公司最喜欢的东西:
免费、可改、没有黑盒。
但真到了一个复杂 SoC 里,反而没人敢轻易拍板:
这个核,谁能保证它没错?
有意思的是,系统越小,这个问题反而越容易回答。
甚至放到昆泰芯这种编码器芯片上,我觉得逻辑会完全倒过来。
01 编码器芯片其实特别适合说明这件事
以 KTM5200 这一类磁编码器芯片为例。
一颗编码器真正最核心的事情是什么?
不是跑操作系统。
不是跑 Linux。
甚至不是跑复杂软件。
真正要命的是那条角度链路:
磁敏前端进来,信号调理,采样,角度计算,误差补偿,最后把位置快速吐出去。
KTM5200 这类芯片面对的已经是接近 MHz 级的内部角度更新需求。
而外面的伺服控制环,很多其实还在 10 kHz 这个量级。
这两个时间尺度差了接近两个数量级。
也就是说,在这种芯片里面,有些事情天生就不应该交给 CPU。
比如最核心的:
每一个采样点都必须准时完成的角度数据通路。
这种东西最适合固定硬件。
延迟是多少,就是多少。
上一拍进来,后几拍出去。
没有 Cache miss。
没有中断抢占。
没有一个任务突然多执行了几十条指令。
它甚至不应该依赖“CPU 今天状态很好”。
02 但芯片里面又确实有很多事情很适合 CPU
问题是,现代编码器又不是只算一个 ATAN2 就结束了。
NVM 要管理。
启动时要加载校准参数。
SPI、ABI、UVW 等接口可能有配置。
工厂测试要跑。
诊断状态要处理。
温度补偿参数可能要更新。
甚至客户现场还会希望增加某些软件可配置功能。
这些东西如果全部用状态机硬写,最后 RTL 会越来越难维护。
于是小 CPU 就变得非常诱人。
这个时候开源 RISC-V 的价值突然出来了。
因为对于编码器芯片来说,我根本不需要一个“无所不能”的 CPU。
我反而希望它:
什么都别能干。
没有 MMU。
最好没有复杂 Cache。
没有多核一致性。
没有乱七八糟的 speculative execution。
能访问哪些寄存器,给它框死。
能操作哪些 SRAM,给它框死。
实时角度链路甚至不要让它碰。
03 这时候“CPU 有没有 Bug”突然没那么重要了
这句话听起来很危险。
但芯片设计真正有意思的地方就在这里。
如果 CPU 掌握了整个系统,CPU 出一个 Bug,可能整个系统都不可预测。
但如果 CPU 只是昆泰芯编码器芯片里面一个 housekeeping controller,事情完全不同。
假设它负责:
启动初始化;
读取 OTP/NVM;
搬运校准系数;
通信配置;
低速诊断;
非实时状态管理。
而真正的高速角度链路全部在硬件里面。
那么就算这个 CPU 某天真的跑飞了,设计者仍然可以提前规定它最坏能干什么。
Watchdog 超时,复位。
非法地址访问,拦住。
配置寄存器写错,保护。
关键参数 CRC 不对,不加载。
核心角度链路异常,直接进入预定义状态。
这时候我们追求的已经不是:
我证明 RISC-V CPU 绝对不会错。
而是:
我证明就算 CPU 错了,它也碰不到最重要的东西。
这是完全不同的可靠性哲学。
04 这也是我越来越觉得“小 RISC-V”比“大 RISC-V”有意思的地方
现在行业讲 RISC-V,最容易兴奋的是:
64 bit。
Linux。
多核。
AI。
服务器。
去替代 ARM。
但从真正做芯片的角度看,我反而越来越喜欢另外一条路线。
CPU 越小,越容易建立可信边界。
Ibex 已经公开过基于 RISC-V Sail specification 的形式化正确性工作。
但这个事情最值得注意的并不是“终于有人证明 CPU 没 Bug”。
因为 formal proof 从来都有边界。
证明的是某个配置。
某个 specification。
某个 abstraction。
Instruction fetch 怎么处理、外部 memory 怎么响应、哪些 implementation behavior 被包含进去,都必须明确。
所以最后工程上真正的问题并不是:
这个 CPU 被证明了吗?
而是:
证明覆盖到了哪里?
再往外一步,就是另一个更现实的问题:
你自己的芯片,又让这个 CPU 有多大权力?
05 放到昆泰芯这里,这个问题尤其有意思
做磁编码器,有一个天然优势。
它其实非常适合把芯片切成两层。
下面一层是硬实时世界。
模拟前端、ADC、数字滤波、角度计算、插值、误差修正、输出时序。
这一层讲的是:
确定性。
上面一层则是慢世界。
配置、校准参数、诊断、NVM、工厂测试、通信管理。
这一层讲的是:
灵活性。
如果未来在这样的芯片里引入小型 RISC-V,我觉得正确的姿势并不是:
太好了,以后算法都写 C。
恰恰相反。
应该第一天就画一条红线:
哪些东西永远不能因为 CPU 卡住而停下来。
比如一个伺服系统正在高速旋转。
编码器内部 1 MHz 左右的角度数据更新绝不能因为 CPU 突然处理一个异常,多花了几十个 cycle,就抖一下。
因为客户最后看到的不是:
“CPU 多执行了几十条指令。”
他看到的是:
角度延迟抖了。
再往后就是速度环、电流环、扭矩纹波。
一个看起来很软件的问题,最后可能变成电机在叫。
这就是编码器芯片和通用 MCU 最大的不同。
06 所以开源核最大的风险,其实不是“开源”
很多人看到开源 CPU,第一反应是:
“没人负责。”
但商业 CPU IP 也不意味着数学意义上的零 Bug。
真正值钱的是后面那套东西:
verification plan,
reference model,
regression,
formal,
errata,
configuration management,
长期维护。
OpenHW 当年给 CV32E40P 建工业级验证环境,在 RTL freeze 前公开记录过几十个 RTL issue。
我反而觉得这是好事。
一个 CPU 真正开始成熟的标志,不是没人发现 Bug,而是 Bug 开始被系统性地发现。
对于昆泰芯这种自己做芯片的公司,开源 RISC-V 最有价值的地方甚至就在这里。
RTL 在自己手里。
验证环境能自己跑。
Formal property 可以自己加。
公司真正关心的几个 corner case,完全可以针对性补进去。
而不是对着一个黑盒问:
“你们这个场景测过没有?”
07 最后真正决定我敢不敢用的,不是这个核有多少分
如果今天让我选一个 CPU 放进一颗编码器 ASIC,我大概率不会先去看 CoreMark。
我会先画一张图。
左边写:
CPU 能控制什么。
右边写:
CPU 永远不能控制什么。
然后再问:
CPU 卡死,角度还能不能正常出来?
Firmware 写飞,关键校准参数会不会被破坏?
CPU 输出错误配置,硬件有没有最后一道检查?
总线 transaction 卡住,会不会拖死实时数据通路?
这些问题能回答,我才敢往下走。
所以我现在越来越觉得:
开源 RISC-V 真正适合的第一批大量落地场景,未必是最复杂的 SoC。
反而可能就是昆泰芯这类传感器芯片、编码器芯片、模拟混合信号芯片里的小控制核。
因为这些系统有一个非常难得的条件:
CPU 可以被关进笼子里。
而芯片可靠性做到最后,最让人安心的从来不是:
“我相信这个 CPU 不会出错。”
而是:
“我知道它出错以后,最多能错到这里。”
对于一个要交出去流片的 GDS 来说,
这两句话之间的距离,
可能就是“敢用”和“不敢用”的距离。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。