一颗磁编码器的量产门槛:三温标定1200万片每年怎么算出来的
首发于公众号「如是有为」 · 查看原文
八月,美新半导体在芜湖办了一场产线启动、研究院揭牌暨新品发布会,发了一颗基于 AMR 的磁编码器。
行业号转的基本都是同样几行参数:角度 INL 小于 ±0.07°,最大测量转速 12 万 RPM,3×3 mm 封装;官网产品页上写着 21 bit SPI 10 MHz、12 bit PWM、ABZ 1–16384 PPR、UVW,VDD 3–5.5 V。
同一场发布会还给了另一个数:
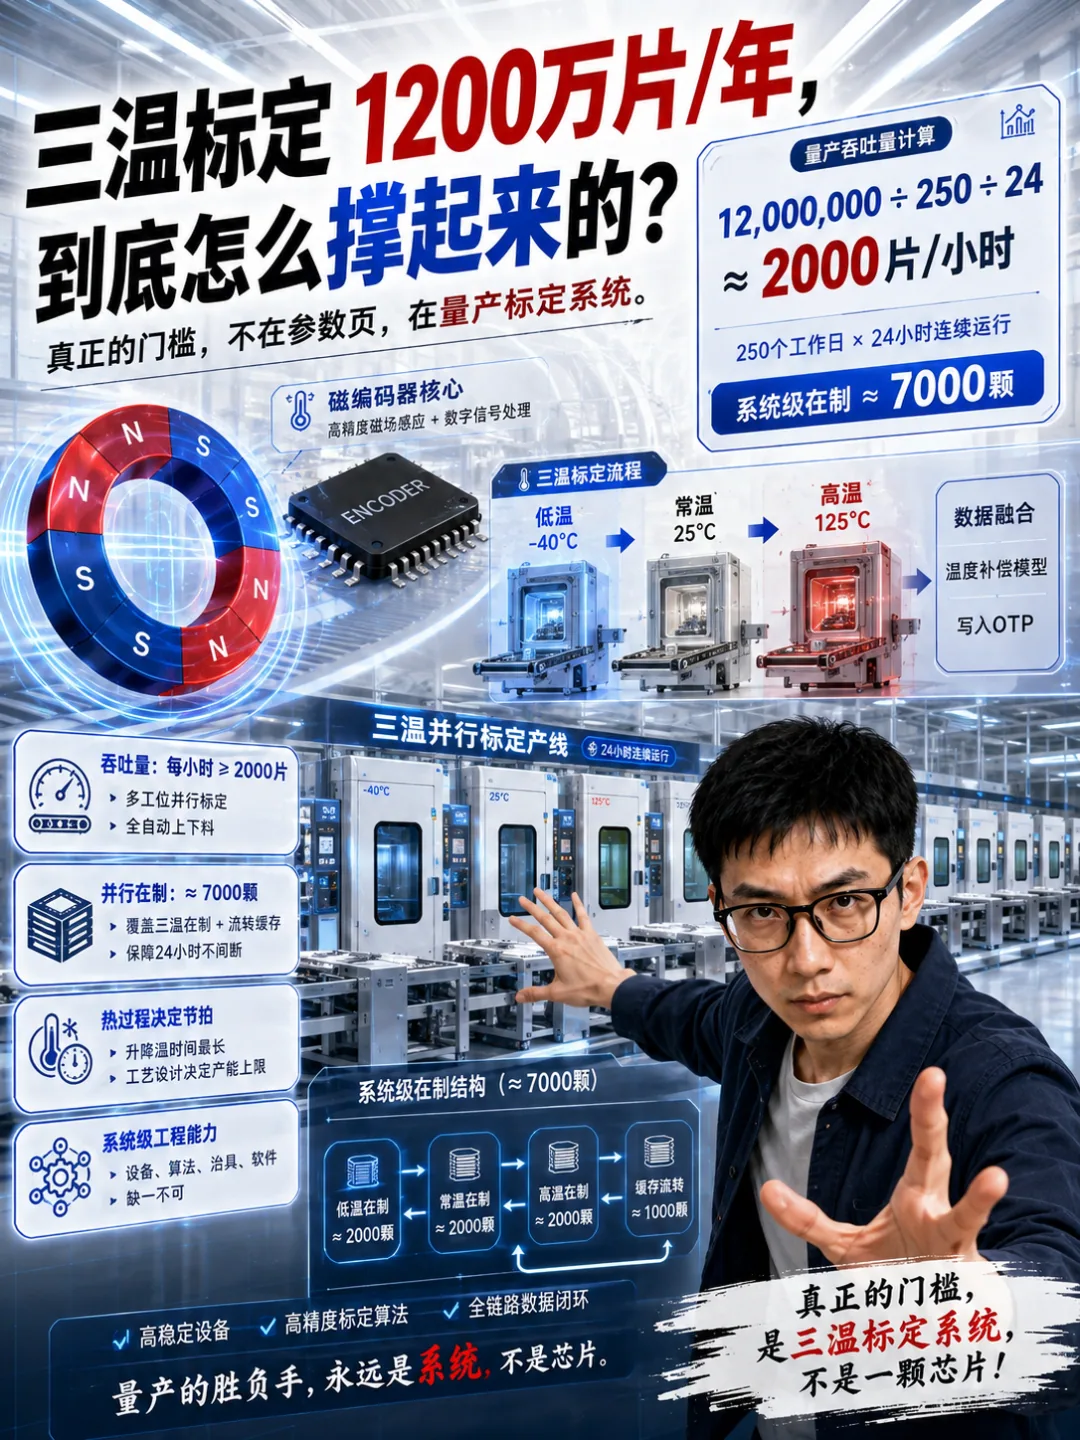
三温标定产能 1200 万片/年,而且还在扩。
这个数我在不少转载里都没看到有人展开说。
但我拿计算器算了一遍以后,反而觉得它比前面那一整排参数,更能说明磁编码器真正的量产门槛在哪里。
通稿里不起眼的那个数
才是产线真正要算的账
INL 小于 ±0.07°,首先说明的是器件能力。
它背后是 AMR 桥路、模拟前端、解调、谐波误差、通道匹配和补偿算法共同做到的结果。
但“三温标定 1200 万片/年”说的是另一层东西。
它不是告诉你这颗芯片理论上能做到多准,而是在告诉你:
为了让几百万、上千万颗芯片都以接近同样的状态出厂,后面要配多大规模的温度标定基础设施。
磁编码器的角度误差并不是一个与温度无关的常数。
温度变化以后,AMR 桥路的 offset、两路增益匹配、正交误差、模拟前端漂移都会变化;外部磁铁的场强也会随温度变化,如果工作点逐渐逼近传感器的磁场边界,同样会侵蚀最终角度性能。
所以要把宽温区精度真正做到量产一致,通常不能只看 25°C 下的一次测试。
需要通过多个温度点建立或验证补偿模型。
具体是两温、三温还是更多温度点,取决于器件本身的漂移特性、目标精度,以及补偿模型怎么设计。
美新这次公开强调“三温标定”,真正值得注意的不是“三”这个数字本身,而是它已经把温度标定做成了一项明确的量产能力。
这件事很重要。
因为数字测试可以快,SPI 可以快,FPGA 可以快,但只要你的工艺仍然要求芯片真实经历几个稳定温度点,那么其中有一部分时间是算力解决不了的。
芯片得真的热起来,也得真的冷下来。
1200 万片一年
先换算成每小时
到底是多少
先不猜它有几台箱,也不猜每台箱塞多少颗。
只算最基础的一笔账。
1200 万片每年。
如果为了估量级,暂时假设一年有效运行 250 天,每天连续运行 24 小时:
也就是说:
平均每小时要完成约 2000 颗三温标定。
这个数字不是美新公布的实际 hourly throughput,只是把 1200 万片/年的名义产能换成一个更容易理解的量级。
如果实际有效设备时间更少,例如一年只有 5000 小时,那么平均吞吐还会更高:
如果只有 4000 小时:
所以不管具体班次怎么排,1200 万片这个数字背后对应的,都不是“小批量实验室标定”。
而是每小时数千颗级别的量产吞吐。
真正惊人的不是单炉多少颗
而是系统里要同时压着
多少颗芯片
再做第二个量级估算。
一个完整的多温度标定流程,通常不会只有采数本身。
还会包含装载、温度切换、热稳定、数据采集、必要的系数计算、写入或验证,以及最后卸载。
其中最难压缩的往往不是 SPI 传输时间,而是热过程。
为了估量级,我们暂时假设一颗器件从进入三温标定流程到离开,平均占用时间约 3.5 小时。
注意,这个 3.5 小时不是美新披露值,只是一个工程假设。
那么按照稳态生产中的 Little’s Law:
如果平均吞吐为:
平均流程时间为:
那么:
也就是说,在这个假设下:
整个三温标定系统里,平均会有大约 7000 颗芯片同时处于在制状态。
这个 7000 不是“某一台温箱里塞了 7000 颗”。
它可能分布在多台温控设备、多个测试站、多个 tray,甚至处于不同的温度阶段。
但这个数量级已经很说明问题了。
你要稳定做出 1200 万片/年,真正需要建立的不是“一台测试机”。
而是一整套可以同时管理数千颗 DUT 的温度标定系统。
这才是量产门槛。
为什么把 SPI 从 4 MHz
拉到 10 MHz
不一定能救这条线
做测试的人有一个很自然的习惯:优化单片节拍。
SPI 慢,就把 SPI 拉快。
一次采 256 点太久,就降到 128 点。
MCU 算得慢,就把计算搬到 FPGA。
这些方法在常温终测里往往很有效。
但到了多温度标定,情况会变。
假设一整个 cycle 里,大部分时间消耗在温度变化和热稳定上,那么电气采集部分哪怕砍掉一半,对总 cycle time 的改善也可能有限。
可以把一炉的时间粗略拆成:
如果真正占大头的是:
那么你优化:
边际收益就会越来越小。
这就是温度标定和普通电性终测最大的区别之一。
前者有一部分时间常数来自热学,后者更多来自电子学。
当然,这并不意味着测试时间“不重要”。
如果每颗器件还要做大量角度扫描、参考编码器同步、多 site 通信、OTP 写入和 verify,那么测试架构依然可能成为瓶颈。
但你至少不能指望只靠把通信和计算做快,就线性地把三温产能翻倍。
真正能动的
是并行度
温度策略
和芯片本身
如果热过程已经成为主导,产能通常只能从几个方向继续挤。
第一是增加并行设备。
更多温控设备、更多 test site、更高并行度,最直接。
但这意味着设备、工装、测试通道、上下料、维护和场地都要跟着增加。
所以温度标定能力做到千万片级以后,它已经不是一个“测试程序优化”的问题,而是制造基础设施问题。
第二是提高单位设备的并行度。
同一批次同时处理更多器件,当然能提高吞吐。
但并行不是无限加。
测试 site 越多,工装越复杂,温度均匀性、信号完整性、供电压降、通信调度和 fixture matching 都会越来越难控制。
尤其温度标定本身就是在测温度相关误差。
如果不同位置 DUT 的真实结温存在系统性差异,那么这部分误差很可能直接进入最后的补偿系数和量产分布。
它不是那种“一眼就坏掉”的故障。
更可能表现为:
实验室单颗很好看,量产分布却慢慢变宽。
第三是减少温度标定的复杂度。
例如三温变成两温,理论上可以省掉一个温度状态及其相关转换和稳定时间。
但能省多少,并不能简单按三分之一计算。
因为总周期不是三个温度点平均分账。
真正的时间结构取决于:
温度点顺序;
ramp rate;
fixture 热容;
soak 条件;
每个温度点的测试时间;
是否能并行完成部分动作。
更重要的是,减少温度点以后,必须回答另外一个问题:
剩下的数据还能不能把温漂模型约束住。
两温并不是天然不够。
很多传感器完全可以用两温建立一阶温度模型。
第三个温度点的价值在于,它开始让你看到一件事情:
一阶模型到底够不够。
如果三点仍基本落在一条线上,那么两温可能已经足够。
如果中间点明显偏离两端点确定的趋势,那么你就第一次真正看见了曲率和残差。
所以从工程上看:
第三个温度点买到的,不只是第三组数据,而是对温度模型是否失效的一次检查。
最狠的一条路
其实是在芯片设计阶段
就少标一点
还有一条路经常被低估:
不是继续扩测试线,而是让芯片本身变得更容易标。
如果 bridge offset drift 更小、两通道匹配更稳定、片上温度传感器更准、前端 gain drift 更低,那么逐颗需要识别的参数就可能减少。
如果产品可以通过大量 characterization 建立稳定的物理模型,也有可能把一部分逐颗标定工作,转成“少数样本 characterization + 少量逐颗 trim”。
这也是为什么温度标定从来不只是测试部门的事情。
它应该在产品定义阶段就被考虑。
片上要留多少 NVM?
系数是一次写入还是多段写入?
是否支持多 site 并行通信?
标定数据如何压缩?
温度补偿是一阶还是高阶?
哪些参数必须逐颗测,哪些可以由 wafer-level 或 lot-level characterization 给出?
这些选择在流片之前就已经开始决定后面的产能。
所以一个磁编码器设计做得好不好,不只是看:
“我能不能做到 ±0.07°。”
还要看:
“为了把这 ±0.07° 稳定地交付一千万颗,我每颗要付出多少标定成本。”
这两个问题完全不是一个问题。
放到机器人里
这个数字就更有意思了
再把 1200 万片放到今年最热的人形机器人场景里。
一台人形机器人需要位置反馈的轴很多。
具体数量取决于自由度定义、灵巧手方案以及是否采用双编码器。
先不押具体 BOM,只做量级计算。
如果平均每台使用 40 颗:
十万台机器人就是 400 万颗。
如果部分关节采用电机侧和输出侧双位置反馈,平均数量进一步上升到 80 颗:
就是 800 万颗。
对一条名义三温标定能力 1200 万片/年的产线来说:
以及:
当然,这只是量级演算,不代表某一家机器人厂真实会下这样的订单,也不代表真实 BOM 就是 40 或 80 颗。
但它能说明一个很现实的问题:
当一个客户开始进入百万颗、几百万颗级别以后,他关心的就不会只剩 INL。
他会问:
你一年到底能标多少?
旺季还能不能加?
设备出了问题有没有冗余?
换型需要多久?
复测会不会堵住正常产能?
这些问题听起来不像芯片设计问题。
但真正到了量产,它们比少 0.01° INL 更接近订单能不能交出来。
我反而先看这三个数
第一,标定产能是多少片每年。
这个数不能替代精度指标,但它直接反映产品有没有跨过从“做得出来”到“批量交得出来”的那条线。
第二,需要几个温度点。
不是因为三温天然比两温高级。
而是因为这个数字在某种程度上反映了器件温漂、补偿模型和制造策略之间的取舍。
如果两温就能稳定做到目标精度,那是设计和模型能力。
如果必须逐颗三温甚至更多温度点,那么后面的制造成本一定会跟着上升。
第三,这个产能到底是什么口径。
是设备理论满载?
还是考虑 uptime、换型、复测和首次通过率之后真正可以交付的产能?
这两个数字可能差很多。
尤其到了高精度传感器量产阶段,真正值得看的已经不只是 best case。
而是分布。
平均值多少,标准差多少,温区边缘多少,lot-to-lot 怎么漂,Cpk 能不能守住。
实验室里一颗芯片做到 ±0.05°,当然很漂亮。
但制造真正难的是:
第一百万颗和第九百万颗,能不能还是同一颗芯片。
最后把这篇文章最开始的那笔账说清楚。
1200 万片/年,是美新公开给出的三温标定产能。
而文中用到的 250 个运行日、24 小时连续运行,以及 3.5 小时平均三温流程时间,都是为了估算量级而做的假设,不是厂商披露的数据。
所以:2000片/小时不是美新的实际产线节拍。
7000颗也不是某一台温箱的实际装载量。
它只是告诉我们:
一旦三温标定真正做到千万片级,这就必然是一套数千颗级并行在制、数千颗每小时吞吐的量产系统。
具体有几台箱、多少 site、每台设备多少 DUT,公开信息还不足以反推。
但有一件事情已经足够明确:
这道工序的核心约束里,有一部分来自热学,而不是算力;真正决定量产上限的,也不再只是芯片设计,而是设计、温度模型、测试并行度和制造基础设施一起决定。
参数表上那一行,是拿来比的。
温箱里那几个小时,才是拿来交货的。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。