AI+传感器,真正值钱的不是给芯片塞一个神经网络
首发于公众号「如是有为」 · 查看原文
SENSOR × AI / 产品路线判断
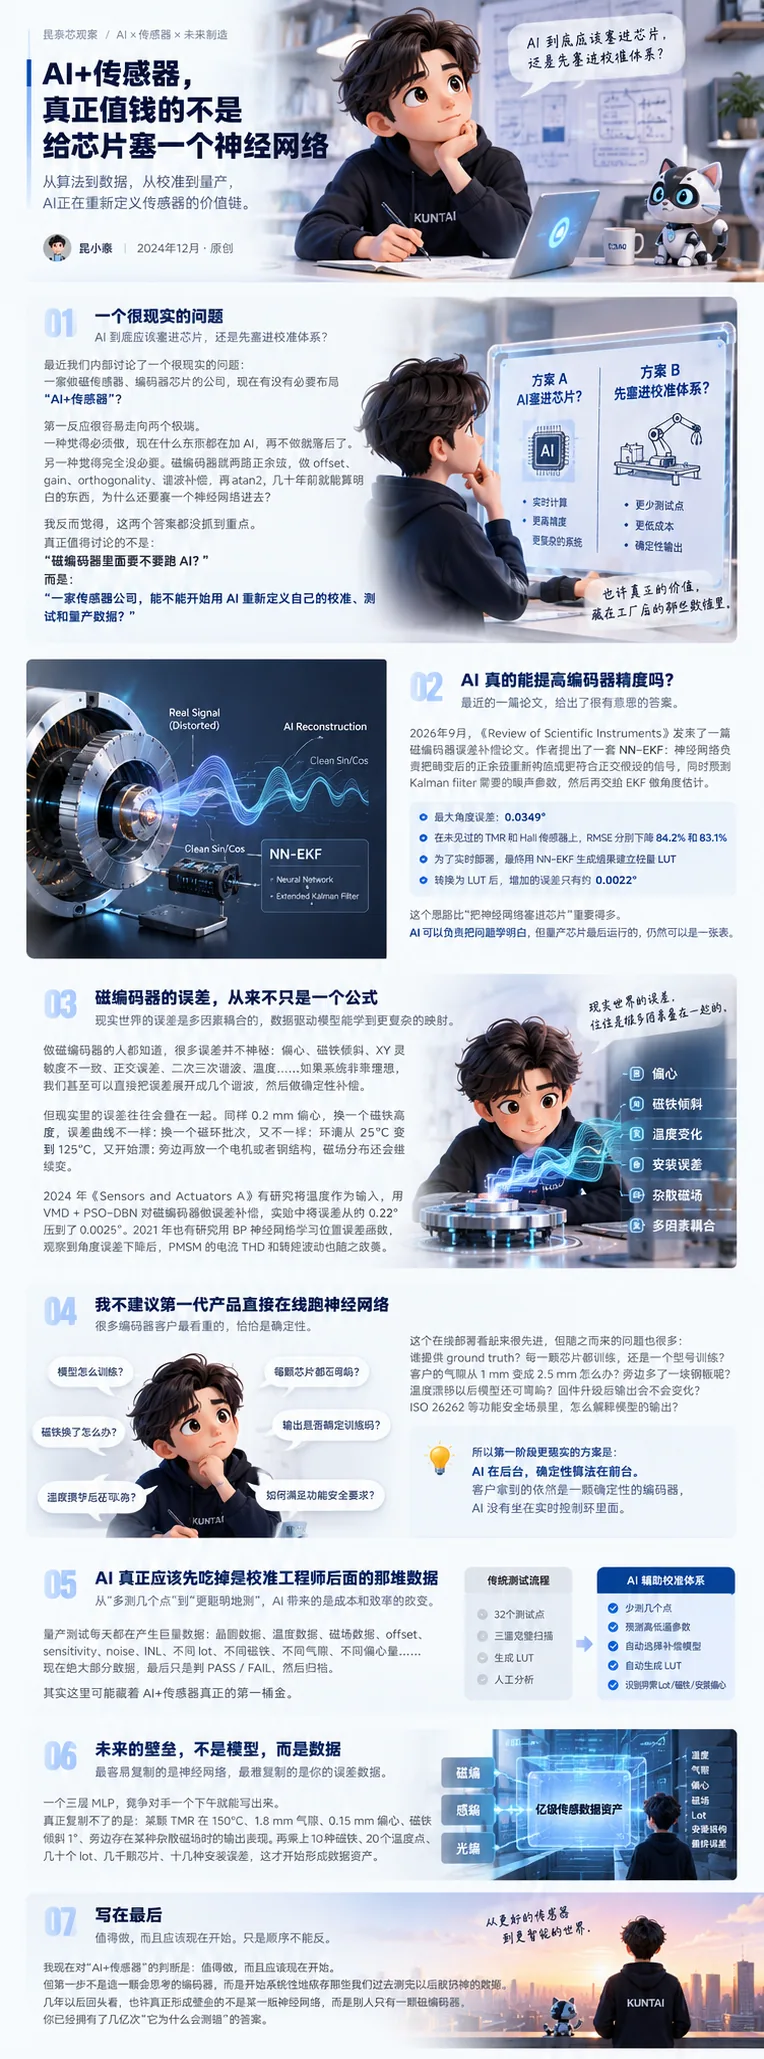
对磁编码器公司来说,AI 最先该进入的,可能不是实时角度链路,而是校准、测试和量产数据。
最近内部聊到一个很现实的问题:一家做磁传感器、编码器芯片的公司,现在有没有必要布局“AI+传感器”?
第一反应很容易走向两个极端。一种觉得必须做,现在什么东西都在加 AI,再不做就落后了;另一种觉得完全没必要,磁编码器就是两路正余弦,offset、gain、orthogonality、谐波补偿、atan2,几十年前就能算清楚的东西,为什么还要塞一个神经网络进去?
真正应该问的不是
“磁编码器里面要不要跑 AI?”
而是:一家传感器公司,能不能开始用 AI 重新定义自己的校准、测试和量产数据?
01
刚刚有篇论文,把这件事做得很有意思
2026 年 9 月,《Review of Scientific Instruments》发表了一篇磁编码器误差补偿论文。作者面对的还是我们天天碰到的那些老问题:正余弦结构失真、噪声,以及传统固定参数滤波器在复杂误差下适应能力不足。
他们做了一套 NN-EKF:神经网络负责把畸变后的正余弦重新构造成更符合正交假设的信号,同时预测 Kalman filter 需要的噪声参数,再交给 EKF 做角度估计。
硬件测试结果
最大角误差 0.0349°
在未针对目标传感器微调的情况下,对未见过的 TMR 与 Hall 传感器,RMSE 分别下降 84.2% 和 83.1%。
最有意思的是后面一步:作者为了实时部署,并没有坚持让神经网络一直在线跑,而是利用 NN-EKF 输出构建轻量 LUT。转换成 LUT 以后,额外误差约为 0.0022°。
AI 可以负责把问题学明白,但量产芯片最后运行的,仍然可以是一张表。
02
磁编码器的误差,从来不只是一个公式
偏心、磁铁倾斜、XY 灵敏度不一致、正交误差、二次三次谐波、温度、气隙、磁铁批次、杂散磁场——单独拿出来,每一个都可以建模。真正麻烦的是它们经常一起出现。
同样 0.2 mm 偏心,换一个磁铁高度,误差曲线就可能不一样;换一个磁环批次,又会变;环境从 25°C 到 125°C,再叠加电机钢件和杂散磁场,最后看到的往往已经不是一条漂亮的二次谐波。
传统路线是把认识的误差一个一个拆开建模;数据驱动路线则可以先让模型学习:这些误差组合起来以后,到底长什么样。
2024 年《Sensors and Actuators A》的一项研究把温度引入磁编码器误差预测,用 VMD + PSO-DBN 做补偿,在其特定实验平台上把误差从约 0.22°压到 0.0025°。这个数字不能直接当作量产产品指标,但它至少说明:当结构误差、温度和非线性耦合以后,数据驱动模型确实能学习到传统单项补偿不容易描述的映射。
03
我反而不建议第一代产品直接在线跑神经网络
假设现在有一颗磁编码器 ASIC,传统路径是 Hall/TMR → ADC → offset/gain 校正 → atan2 → LUT → 数字接口。然后突然在 ADC 后面塞一个小神经网络,宣布下一代叫 AI Encoder,看起来很先进,但工程问题会马上成倍增加。
这个网络什么时候训练?谁提供 ground truth?每颗芯片都训练还是一个型号训练?磁铁换了怎么办?气隙从 1 mm 变成 2.5 mm 怎么办?旁边多了一块钢板怎么办?温漂以后模型还可靠吗?固件升级以后输出会不会变化?
编码器客户喜欢的,恰恰就是确定性。同样的输入、同样的寄存器配置、同样的芯片,希望十年以后还是那个结果。所以第一阶段最现实的路线可能是:
AI 在后台,确定性算法在前台。
让 AI 负责建模、预测与参数生成,让实时控制链路继续保持可验证、可复现、可追溯。
04
AI 真正应该先吃掉的是校准工程师后面的那堆数据
一家传感器公司只要进入规模量产,晶圆测试、温箱、磁场扫描、转台、OTP 校准每天都在产生数据:offset、sensitivity、noise、INL、lot、封装、磁铁、气隙、偏心、温度……过去其中很大一部分最后只变成 PASS / FAIL,然后归档。
但这里才可能藏着 AI+传感器真正的第一桶金。
过去:32 个点做校准。
以后:前几个点先识别误差族,只补测真正有信息量的点。
过去:三温全部完整扫描。
以后:用 wafer + room-temperature 数据预测 hot/cold 风险,只对高风险 die 做完整验证。
过去:测完以后逐颗生成 LUT。
以后:模型根据少量采样点预测完整误差曲线,最终仍然写入传统 LUT 或 calibration coefficients。
注意这个路线最关键的地方:客户最后拿到的依然是一颗确定性的编码器。AI 没有坐进实时控制环,它只是站在工厂后面,把过去必须测 32 个点才能得到的结果,尝试变成 8 个点、12 个点,或者更聪明的自适应测试序列。
一旦成立,AI 带来的就不只是精度,而是测试时间、UPH、温箱利用率、测试机数量、OTP 参数数量,最后全部变成成本。
05
最容易复制的是神经网络,最难复制的是误差数据
一个三层 MLP,竞争对手一个下午就能写出来。真正复制不了的是:某颗 TMR 在 150°C、某个气隙、某个偏心、某种磁铁倾斜、某批磁铁和某种杂散磁场条件下,最后会输出什么。
再乘上不同 lot、不同封装、不同安装结构、不同客户模组和多年量产历史,这才开始形成一家传感器公司的数据资产。
TDK 在 2026 年推出 SensorGPT,路线也不是简单地把一个“GPT”塞进某颗传感器,而是用生成式 AI、信号处理、统计方法和仿真去生成、扩充和管理传感器数据,直接瞄准数据采集成本和 edge AI 的训练瓶颈。
06
那昆泰芯这样的公司,第一步该做什么?
我不会首先立一个项目叫“AI 磁编码器”。太容易最后做成 Demo。
我反而会先建立统一的 Sensor Error Database。磁编、感编、光编都往里面灌:原始 ADC、sin/cos、角度、参考编码器角度、温度、转速、气隙、偏心、倾斜、磁场强度、芯片 lot、磁铁 lot、PCB、客户模组、最终误差。
一开始甚至不需要任何 AI。先把数据结构和采集规则定义好。因为半年以后真正想训练模型的时候,网络随时可以写,两年前没有保存下来的那批数据,再也找不回来了。
真正的路线图
先统一误差数据 → 再做离线建模 → 再自动生成 LUT / 参数 → 再缩短量产测试 → 最后才判断哪些模型值得进入实时链路。
如果磁编、感编和光编最终都能用同一套“误差语言”描述,公司积累的就不再只是某一颗芯片的 calibration algorithm,而是一套跨传感原理的 position sensing model。
07
所以我现在反而不太喜欢“AI Sensor”这个词
它太容易让人想到:芯片里有个 NPU,跑着一个神经网络,然后包装盒上印一个 AI。
但对磁编码器这种产品,AI 第一次真正产生商业价值的地方,很可能非常不起眼:少测几个点,少进一次温箱,自动找到异常 lot,自动选择补偿模型,自动生成 LUT,识别异常磁铁,识别安装偏心,最后把复杂世界压缩成几个确定性的 calibration coefficients。
几年以后真正形成壁垒的,也许不是某一版神经网络。
而是别人只有一颗磁编码器,你已经拥有了几亿次“它为什么会测错”的答案。
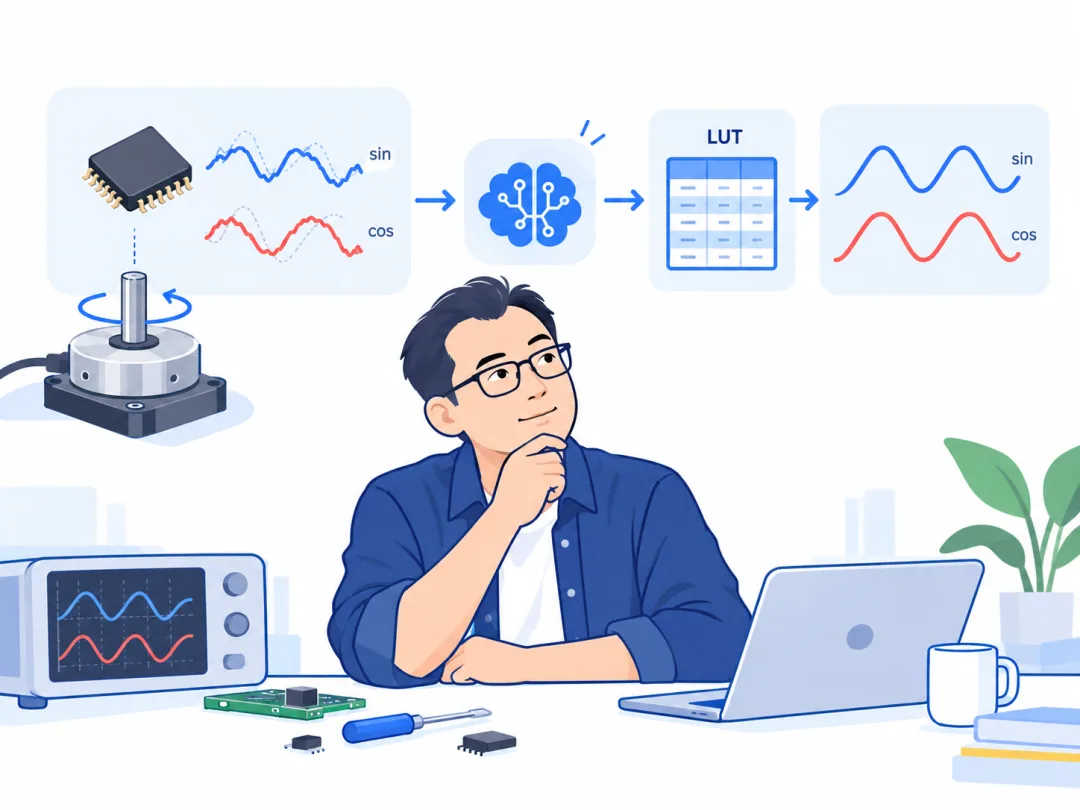
AI 学习复杂误差,最终仍然可以把结果压回确定性的 LUT。
参考资料
Magnetic encoder error compensation based on a neural network-Kalman filtering hybrid framework, Review of Scientific Instruments, 2026. https://pubmed.ncbi.nlm.nih.gov/42695778/
A compensation approach for magnetic encoder error based on improved deep belief network algorithm, Sensors and Actuators A: Physical, 2024. https://www.sciencedirect.com/science/article/pii/S092442472300852X
TDK develops SensorGPT™, 2026-05-05. https://www.tdk.com/en/news_center/press/20260505_01.html

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。