Unitree G1 Edu-U4 主动双目做到94.4%,但加Dex3-1指端压力掉到67.3%,会让分拣策略把噪声当证据
首发于公众号「如是有为」 · 查看原文
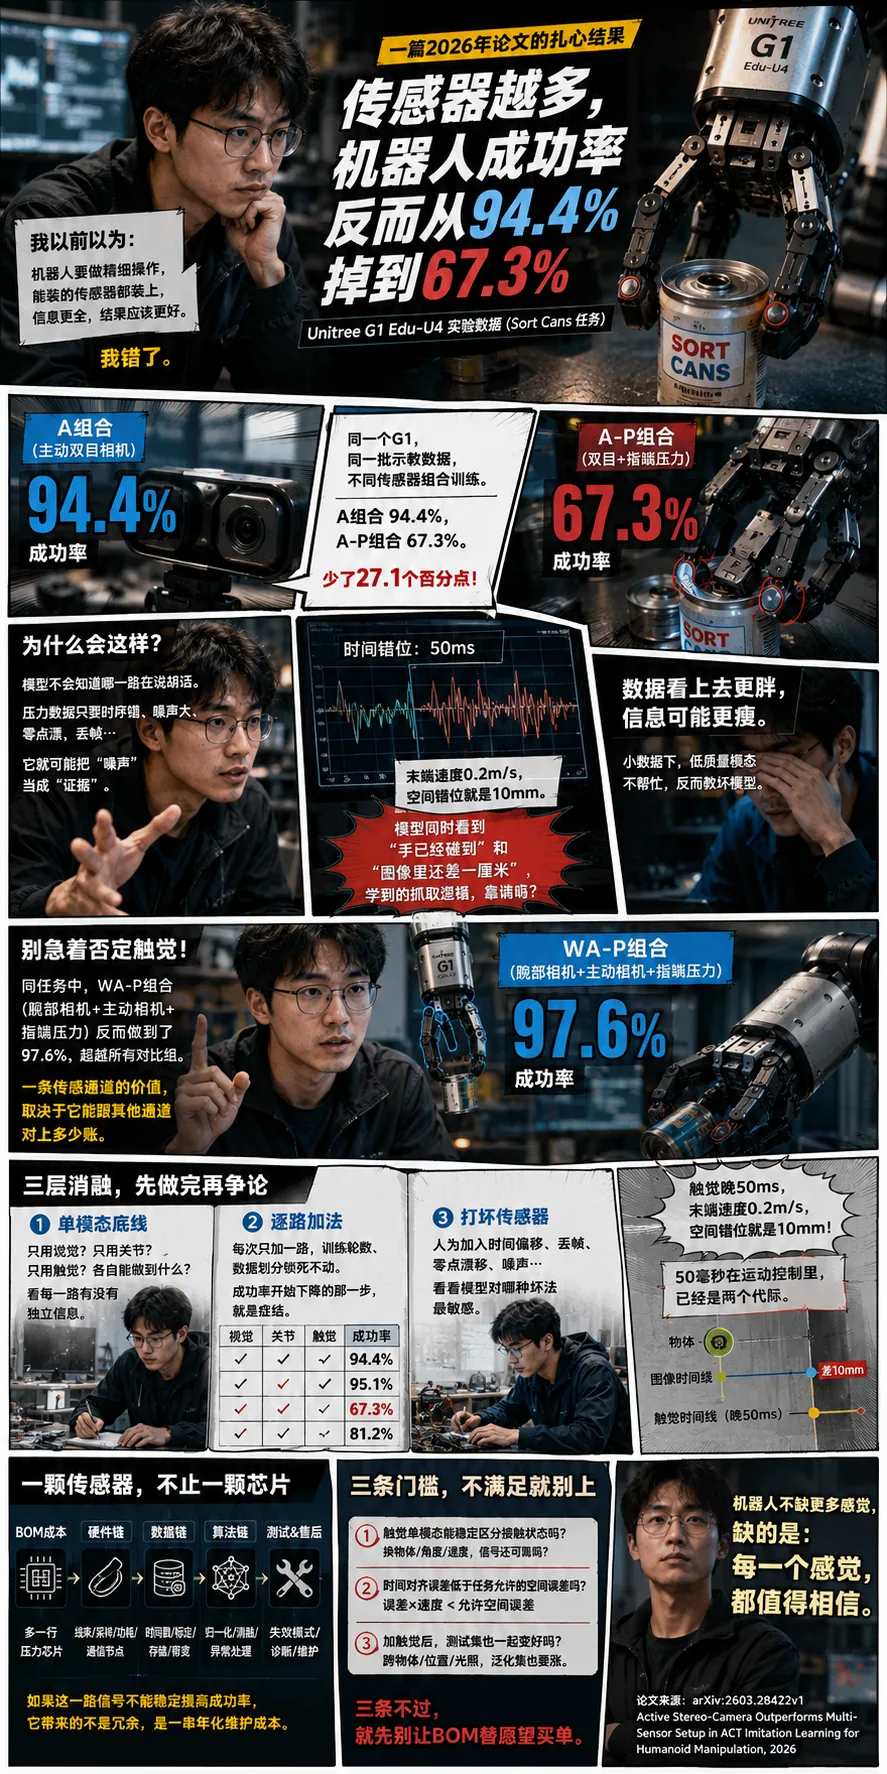
Unitree G1 Edu-U4 上,同一个 Sort Cans 结构化分拣任务,只用主动双目相机的 A 组合做到 94.4%;加入 Dex3-1 三指手指端压力后,A-P 组合掉到 67.3%。不是因为压力传感器一定没用,而是因为在小数据模仿学习里,一路低任务相关信噪比的新模态,可能会被模型认真当成证据。
我以前很容易相信一件事:机器人要做精细操作,视觉、触觉、压力、关节位置,能装的都装上。信息更全,结果应该更好。
这篇 2026 年的人形机器人模仿学习论文,把这个直觉打穿了。研究者在 Unitree G1 上比较 14 种传感器组合,并使用 sensor masking 的消融框架,尽量减少不同示教数据带来的混杂变量。结果里最扎眼的一组数字是:A 组合,也就是主动双目相机,在结构化操作任务里做到 94.4%;A-P 组合,也就是主动双目再加指端压力,成功率反而掉到 67.3%。
不是差 2.7 个点。
是少了 27.1 个百分点。
你多加了一路传感器,你的机器人反而不会干活了。
论文没有证明"触觉没用"。更准确地说,它证明了一件更工程化、也更麻烦的事:在小数据模仿学习里,低质量或低任务相关信噪比的新模态,不是一个"没帮忙的队友",它可能是一个会教坏模型的内鬼。
而且这个内鬼,比真正的缺失更难排查。
你的算法不会告诉你:“这路信号在胡说”
工程师看传感器,习惯看量程、分辨率、带宽和噪声。但学习模型看到的只是一串张量。它不分辨"哪个传感器更可靠",只要接口尺寸对得上,它就认真吸收,一视同仁地学。
压力数据如果零点漂、接触面积变化大、采样频率低,或者跟图像和关节状态的时间戳差了几十毫秒,模型不会礼貌地把它放到一边。它可能把偶然的压力尖峰当成"抓稳了",把缺失帧当成"物体已经离手",甚至学到某个训练工装独有的接触纹理,换一个工装就全垮。
数据看上去更胖,信息可能更瘦。
在小数据场景里,这件事尤其阴险。视觉信号每一帧都在,压力信号只在接触瞬间出现。有效样本比例本来就低。再塞几十个压力通道进去,模型参数多了解释训练集的自由度,却没有多得到理解真实任务的证据。
它不只是"多一路输入"。
它可能是模态污染。
更扎心的是:压力传感器不是总坏事
这里必须补一个边界声明,因为这恰恰是工程师该看懂的细节。
在同一个结构化任务里,论文还有一个组合:WA-P。也就是腕部相机、主动相机,再加指端压力。这个组合的成功率是 97.6%,比主动双目单独的 94.4%还高。
所以,问题不是"压力有没有用"。
真正的问题是:同样是加压力,为什么 A-P 从 94.4%掉到 67.3%,而 WA-P 却能到 97.6%?
论文作者给出的解释方向是:压力数据在有更充分视觉上下文支撑时,可能确实有帮助;但如果视觉锚点不够、数据覆盖不足、任务相关信噪比不高,压力信号就可能变成策略里的伪证据。
一条传感通道的价值,不取决于它自己多好,取决于它能跟其他通道对上多少账。
视觉有空间上下文,压力只有接触瞬间。两者对齐得好,互相加持;对齐得差,互相污染。这不是传感器之争,是信号对齐之争。
别争了,三层消融做完再说话
遇到多传感器方案,我现在会先做一张消融表。不是开会争"触觉是不是刚需",也不是听谁拍桌子说"机器人没有触觉就不高级",而是先把数据烧出来。
第一层,做单模态底线。只用视觉能做到什么?只用关节位置能做到什么?只用触觉能做到什么?这不是为了真的单独部署,而是为了看每一路有没有独立信息。如果某一路单独做不好,不代表它没用,但至少说明它不能单扛。
第二层,做逐路加法。视觉到视觉加关节,视觉到视觉加触觉,再到三者全加。每次只增加一路,训练轮数、数据划分、评估任务尽量锁死不动。成功率开始下降的那一步,就是症结开始暴露的地方。不是猜出来的,是烧出来的。
第三层,做故障注入。注意,不是删掉传感器,而是"打坏传感器":人为加入时间偏移、随机丢帧、零点漂移和噪声,观察模型对哪种坏法最敏感。这层最值钱,也最少有人愿意做,因为它会提前暴露量产现场迟早要暴露的问题。
量产现场里的传感器,从来不会按论文数据集那么整齐。实验室里你以为已经对齐到毫秒级,产线出来以后,一路线束、一层滤波、一个通信周期、一段缓存,都可能把时间戳往后拖。
触觉晚 50ms,末端速度 0.2m/s,空间错位就是 10mm。50 毫秒在运动控制里,已经不是小误差。
模型同时看到"手已经碰到"和"图像里还差一厘米"。它学到的抓取逻辑,你觉得能靠谱吗?
一颗传感器在 BOM 上只占一行,在数据链里会长成三页
加一颗传感器,不止是加一颗芯片。
硬件团队看到的是 BOM 多了一行压力芯片。系统团队看到的是多一条线束、多一个采样任务、多一份功耗预算、多一个通信节点。算法团队看到的是多一组归一化参数、多一轮消融实验、多一套异常处理。测试团队要设计它失效时机器人不能乱动。售后还得判断:到底是传感器坏了,还是模型不再信它了?
如果这一路信号不能稳定提高成功率,它带来的不是冗余,是一串年化维护成本。
这也是为什么关节位置传感器常被低估。位置反馈不性感,它没有压力那么"仿人",也没有视觉那么适合做演示视频。但它每一拍都存在,物理含义稳定,不走神经网络也能进控制闭环。触觉的价值当然很大,但它更依赖接触结构、材料一致性、标定质量、时间同步和任务数据量。
两者不是谁替代谁,而是证据密度不同。
选传感器不是选功能,是选你愿意为哪一路信号承担长期对齐责任。
三条不满足,就先别让 BOM 替愿望买单
论文结果只针对特定任务、特定数据规模和特定传感器配置。数据更多、触觉质量更高、模型能更好处理异步模态时,结果完全可能反转。这个边界一定要讲清楚,否则就会从工程分析滑向情绪判断。
但反转之前,先过三条。
第一,触觉单模态能稳定区分接触状态吗?换一个物体、换一种抓取角度、换一个速度,触觉信号还能重复地告诉你"碰到了"和"没碰到"的区别吗?如果每次接触图样都像随机噪声,那它进模型以后,不会因为名字叫"触觉"就自动变高级。
第二,时间对齐误差低于任务允许的空间误差吗?如果任务要求 ±2mm,时间错位乘以末端速度就不能超过 2mm。超过了,信号就可能不是帮助,而是误导。
第三,加触觉后测试集也一起变好吗?不是只看训练集。跨物体、跨位置、跨光照、跨抓取姿态的测试集都要看。如果训练集涨了,泛化集不涨,甚至还掉,那你加的可能不是传感器,是过拟合加速器。
三条不过,就先别让 BOM 替愿望买单。
传感器的价值不在"我装上了",而在它能不能给策略增加一条稳定、可泛化、坏了也能被识别的证据。94.4% 到 67.3% 这组数字很刺眼,但它提醒得足够诚实:
机器人不缺更多感觉。
它缺的是,每一个感觉都值得相信。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。