特斯拉在删传感器,Waymo 在堆传感器,宇树 G1 到底该学谁?
首发于公众号「如是有为」 · 查看原文
01 评论区这个问题,其实问的是“机器人该怎么相信世界”
之前写宇树 G1 头部的 Intel RealSense D435i 深度相机时,评论区有位读者问:激光雷达不是已经能测距离了吗,为什么还必须有图像深度?激光和图像的深度在应用时到底怎么结合?
这个问题看起来是在问传感器,实际上是在问一个更底层的问题:机器人该怎么相信自己看到的世界。
做芯片和传感器的人,对这个问题会特别敏感。因为我们很清楚,传感器从来不是“参数越高越好”这么简单。真正到客户现场,大家关心的是:这一路数据在什么场景下可信,什么场景下会骗你,出了问题以后能不能解释,能不能降级,能不能闭环。
所以这篇不从 AI 大词讲起,还是从工程现场讲起。
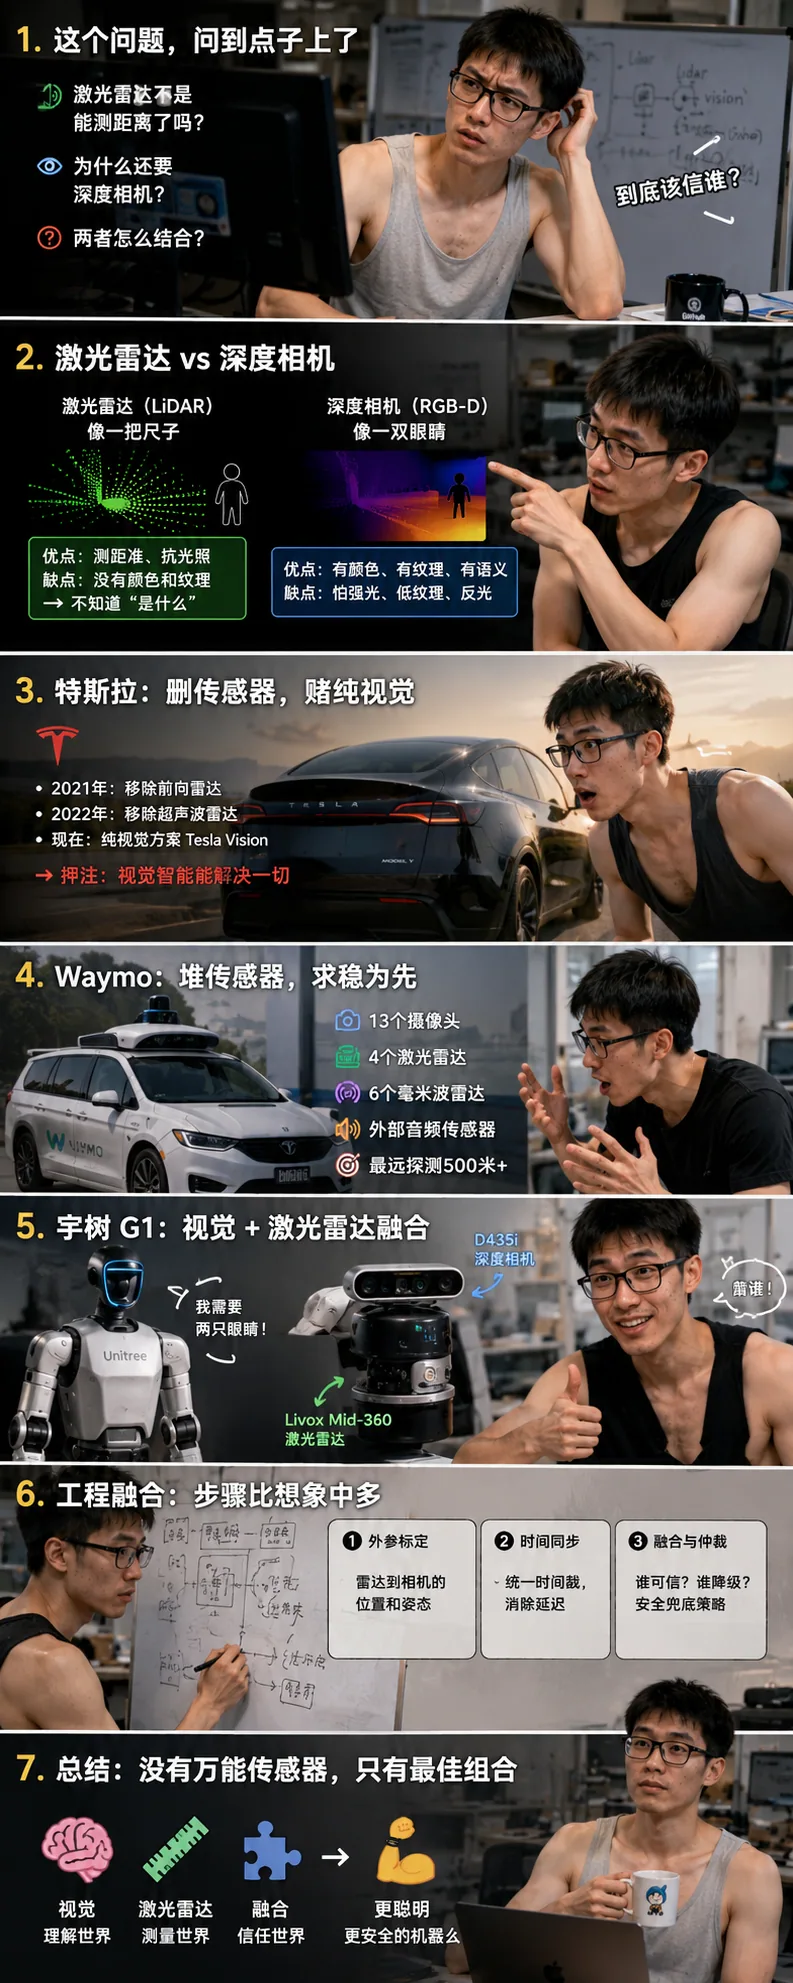
02 激光雷达像尺子,深度相机像眼睛
激光雷达最擅长的是测距。它给你的通常是点云:某个方向、某个角度、某个时间点,距离多少米。这个东西非常像一把会自动扫描的尺子,优点是直接、稳定、几何关系清楚。
但尺子有一个问题:它不知道自己量到的是什么。
一把椅子、一只纸箱、一条狗、一个蹲着的人,在激光雷达眼里都可能先变成一团点。它知道那里“有东西”,但它不知道那个东西的语义。点云有空间,没有纹理;有距离,没有颜色;有轮廓,但不天然带“这是什么”的答案。
深度相机刚好补这件事。它不仅给距离,还把距离和图像绑在一起。也就是说,机器人不只是知道前方 1.5 米有个东西,还能在同一张图里看到轮廓、纹理、颜色、边缘,再交给视觉模型判断:这是人、桌子、台阶,还是玻璃门。
这就是评论里那句“雷达深度几乎没有纹理”的核心意思。激光雷达负责告诉你“东西在哪”,图像深度负责帮助你理解“那是什么”。
03 特斯拉为什么敢删传感器
特斯拉是最极端的一条路线。官方资料显示,特斯拉 2021 年开始从 Model 3 和 Model Y 上移除雷达,转向 Tesla Vision;2022 年又开始移除超声波传感器,让大部分市场的新车依赖基于摄像头的 Autopilot 系统。
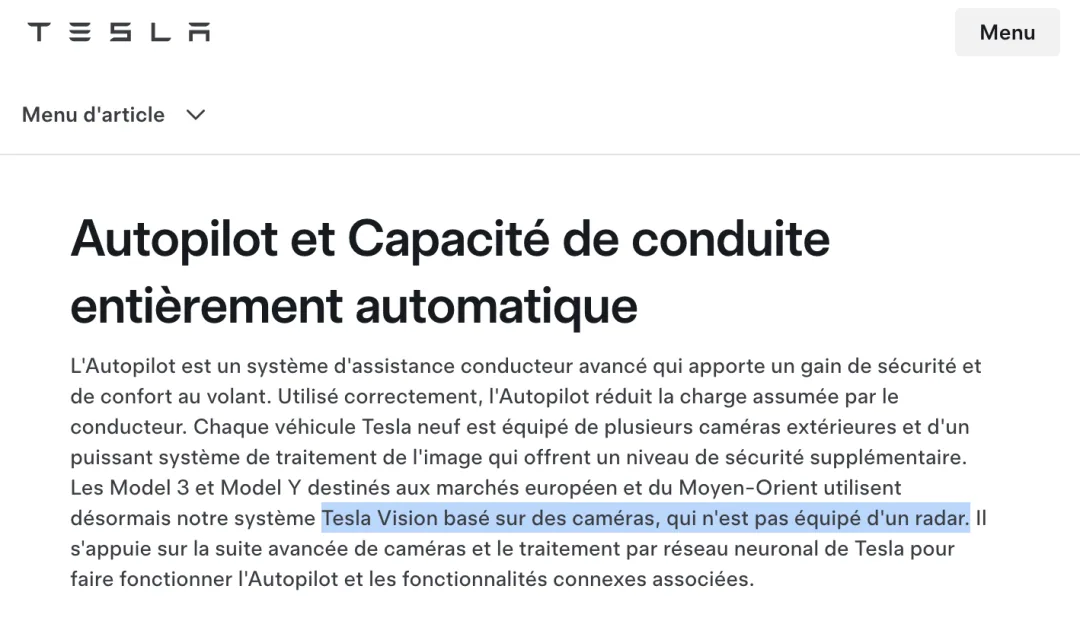
这个动作在工程上非常激进。别人做自动驾驶,通常是摄像头、毫米波雷达、激光雷达、超声波尽量多堆几路冗余;特斯拉反过来,一路一路往下删。
为什么它敢这么做?
因为特斯拉赌的是“视觉智能”。道路世界里大量关键信息本来就是视觉语义:红绿灯颜色、车道线、限速牌、施工标志、前车刹车灯、交警手势。激光雷达可以告诉你红绿灯杆离你多远,但它不知道灯是红是绿;毫米波雷达可以告诉你前面有运动目标,但它不知道路牌上写了什么。
马斯克那套“人类开车不用激光雷达”的说法,很多人不喜欢,但逻辑是自洽的:如果最终目标是让 AI 像人一样理解道路,那么视觉问题不能绕过去。激光雷达可以当尺子,但不能替代眼睛和大脑。
04 Waymo 为什么反过来继续堆传感器
Waymo 走的是另一条路线。它不是删传感器,而是把传感器融合做得更工程化。Waymo 第六代 Driver 公开信息里提到,新系统包含 13 个摄像头、4 个激光雷达、6 个雷达和外部音频接收器,强调用重叠视场覆盖车辆周围,并兼顾白天、夜晚和复杂天气。
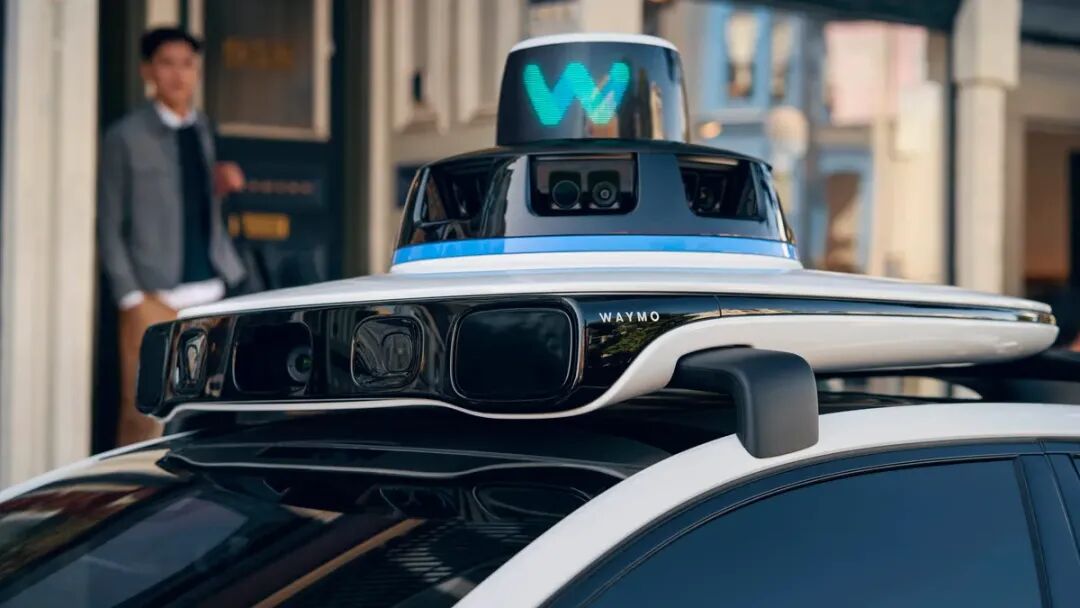
这就是典型的安全冗余思路。摄像头看语义,激光雷达看几何,毫米波雷达看速度和遮挡,声音传感器补充特殊事件。它不像特斯拉那样赌单一路线,而是让多种传感器互相兜底。
工程师其实很容易理解 Waymo 的选择。因为真实世界太脏了。雨、雾、逆光、玻璃、反光车身、黑色物体、遮挡行人,这些都不是论文里的干净场景。Waymo 要运营 robotaxi,车上没人兜底,它必须为极端场景买保险。
所以特斯拉和 Waymo 的分歧,不是“谁懂 AI,谁不懂 AI”。更像两种工程哲学:特斯拉押注视觉模型规模化之后可以吃掉大部分问题;Waymo 押注多传感器冗余可以把尾部风险压下去。
05 宇树 G1 的问题比汽车更像 Waymo,不像特斯拉
人形机器人面对的世界,比汽车还脏。
汽车主要跑在道路上,道路至少有规则:车道、交通灯、限速牌、行人横道。机器人要进家庭、工厂、仓库、办公室,面对的是玻璃门、反光地砖、黑色桌腿、堆起来的纸箱、突然伸出的手、半开的抽屉、低纹理白墙。
这些场景对视觉非常不友好。暗光会让图像噪声暴涨,逆光会过曝,玻璃会反射,黑色物体会吸光,白墙和纯色地面缺少纹理。深度相机在这些地方会出现孔洞、飞点、边缘错误。
但激光雷达也不是万能。它不懂语义,点云稀疏,跟图像对齐还要做外参标定和时间同步。机器人头部一边走一边晃,如果相机帧、雷达点云、IMU 姿态不是同一时刻,融合出来的世界就会错位。
这就是为什么宇树 G1 头上同时出现 D435i 和 Livox MID-360 是合理的:一个提供图像和近距离深度,一个提供更稳定的空间扫描。视觉负责聪明,激光雷达负责兜底。
06 真正难的是融合,不是装两个传感器
很多人以为多装一个激光雷达就安全了。工程上不是这样。
传感器融合最难的是仲裁。视觉说前面是玻璃门,激光雷达点云一片混乱,你信谁?视觉说前面没人,激光雷达扫到一团移动点,你信谁?深度相机说地面是平的,激光雷达说前方有台阶,你让机器人继续走,还是停下来?
这不是算法论文里的“融合一下”。这更像客户现场的故障分析:两路数据互相打架,最后系统必须决定谁可信、谁降权、什么时候触发安全策略。
做编码器的人对这个特别熟。绝对值编码器和增量编码器一起用时,不是两路数据简单平均,而是要判断哪一路在什么工况下可信。启动、掉电、振动、丢脉冲、温漂,每个场景的可信度不一样。机器人感知也是同样逻辑。
激光雷达和图像深度结合,本质上不是“1+1=2”,而是建立一套可信度模型。
07 RealSense 为什么还没死,反而重新被机器人需要
还有一个新闻很值得注意:RealSense 在 Intel 内部发展多年后,2025 年分拆独立,并获得 5000 万美元融资。TechCrunch 的报道提到,RealSense 的应用重点已经越来越集中到机器人等真实物理世界场景,因为这些机器需要实时、高精度地理解周围 3D 环境。
这解释了为什么 D435i 这种看起来不算新的模块,还能继续出现在机器人上。它不一定是参数最漂亮的深度相机,但它是很多工程师熟悉的“默认件”:SDK 熟,ROS 支持熟,坑也踩得差不多了。
国产替代要替掉它,不只是替一个硬件模块。要替的是图像、深度、IMU、时间戳、驱动、SDK、标定文件和客户已经调好的算法参数。
这就像芯片替代一样,最难的不是样品跑通,而是让客户敢在验收表上写“已验证”。
08 结论:特斯拉可以赌视觉,机器人不能只赌一只眼睛
所以回到评论区的问题:激光雷达已经能测深度了,为什么还需要图像深度?
答案是:激光雷达给几何,图像深度给语义入口。激光雷达像尺子,深度相机像眼睛。尺子能告诉你距离,但眼睛才能帮你理解世界。
特斯拉可以激进地押注纯视觉,因为它在赌道路 AI 的规模化学习。Waymo 继续堆传感器,是因为无人出租车要对尾部风险负责。宇树 G1 这类机器人更接近后者,因为它离人更近,环境更乱,摔一下、撞一下的代价更直接。
我自己的判断是:未来机器人不会走纯激光雷达,也不会简单照搬特斯拉纯视觉。更大的概率是视觉越来越强,激光雷达越来越便宜,IMU、编码器、深度相机、激光雷达在同一个时间坐标里融合得越来越深。
真正的机器人感知,不是看见世界,也不是量到世界。
是知道什么时候该相信哪一路传感器。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。