AI已经会思考了,为什么连一颗螺丝都拧不好?
首发于公众号「如是有为」 · 查看原文
从 Gemini Robotics 2 到 NVIDIA Isaac:当人工智能走入真实物理世界,决定下限的可能不是模型,而是传感器、时间与控制闭环。
一台机器人站在工作台前。桌上有一颗螺丝、一把螺丝刀和等待装配的铝制外壳。摄像头识别出了全部物体,模型知道螺纹的旋向,甚至能解释什么是扭矩、什么是交叉螺纹。
可机械手真正下落的时候,麻烦就开始了。孔口偏了半毫米,螺丝头轻轻一歪,手指没有感觉到滑移,电机却仍然在转。语言模型知道应该“轻轻拧入”,控制系统看到的却是一个正在变化的电流波形。
AI 能把装配工艺讲得头头是道,不等于它能在接触发生后的几毫秒里,准确知道自己究竟做错了什么。
这不是要拿工业机器人嘲笑大模型。相反,这恰恰是物理 AI 最值得研究的断层:从符号与语义,到力、位移、摩擦和冲击,信息的性质变了。数字世界允许模型改写答案,真实世界里,一次错误的扭矩就可能让螺纹报废。
从“说出答案”到“产生动作”
2026年7月30日,Google DeepMind 发布 Gemini Robotics 2。它不再满足于让模型看懂图像、回答问题,而是把视觉语言动作模型(VLA)、具身推理模型(ER)和设备端执行模型拆成互相配合的部分。Gemini Robotics 2 把视觉与指令变为机器人动作;ER 2 负责多步骤规划、进度判断与协调;On-Device 2 则强调机器人本地执行。
Google 展示的进展包括灵巧手操作、全身动作和多机器人协作。五指手打结、抓取、整理物体,看起来距离“万能机器工人”只差最后一步。但不要忽略一个词:演示。公开演示证明某些能力已经出现,并不自动等于在随机工况中具备工业量产级的成功率和可维护性。
10月21日,NVIDIA 在柏林公布 Isaac 生态的新扩展。官方资料包括 Isaac OS 运行时、Isaac Lab 3.0、参考人形机器人 Agile ONE SN、Jetson Thor 和训练评估工作流。这说明产业正在把竞争重心从“单个模型会不会完成动作”移向“如何持续地产生数据、训练策略、验证安全并真正部署”。
其中有一个特别值得芯片工程师注意的细节:NVIDIA 公告提到的 Agile ONE SN 双手具备触觉传感和 1 kHz 力控制能力。这当然不是说整个 AI 大模型每毫秒完整推理一次,而是说明高级智能之外,机器人仍需要更快的局部控制回路。
两种时间:大模型的一瞬间,是电机的半圈
一个大模型在几百毫秒内完成一次复杂规划,人们可能会觉得非常快。但电机并不以自然语言的节奏运动。以 3000 rpm 为例,每秒是 50 转。仅仅 10 ms,机械轴已经旋转 180°。
3000 rpm = 50 r/s;10 ms × 50 r/s × 360° = 180°
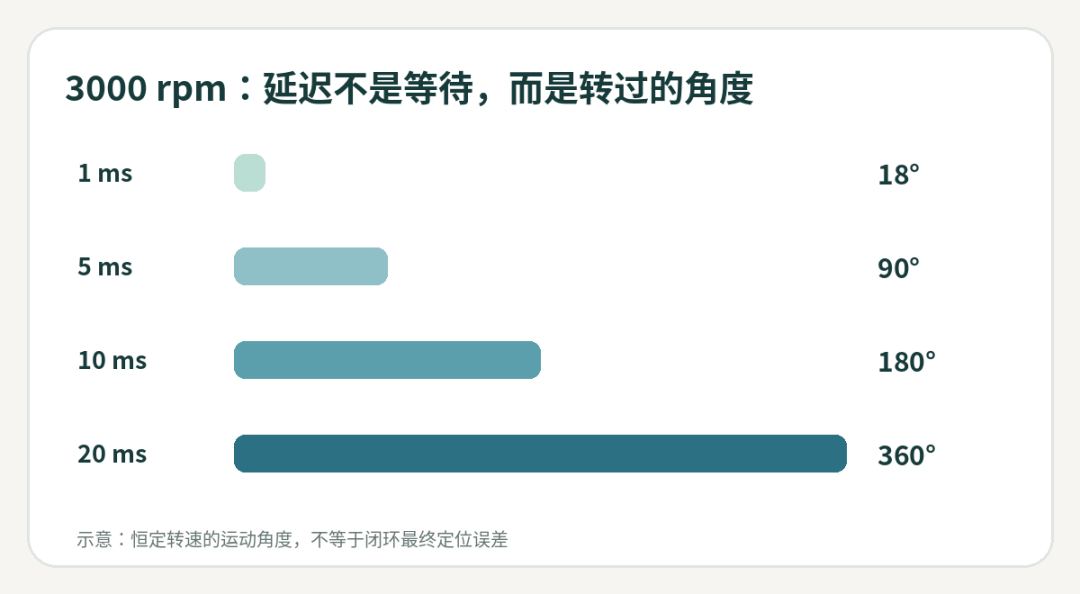
这里必须区分“延迟期间转过的角度”和“最终定位误差”。速度预测、时间戳、前馈补偿和模型观测器都可以部分抵消延迟影响。但在高速场景里,时序不确定性、采样偏斜与指令抖动,无法靠一句“模型足够智能”自动消失。
系统层级 | 典型时间尺度 | 要解决的问题 |
|---|---|---|
语言与任务规划 | 约 0.1 s 到秒级 | 任务、目标、语义 |
动作策略 | 约 10–100 ms 或更长 | 姿态与动作片段 |
运动闭环 | 约 1–10 ms | 位置、速度、力 |
电流闭环 | 约 50–200 μs | 电机转矩快速调节 |
功率调制 | 通常数十 kHz | 逆变器开关 |
以上是跨系统的示例量级,并非 Gemini 或 NVIDIA 某项产品的性能承诺。实际架构可能把策略输出、模型预测控制、状态估计和伺服环做成不同的异步周期。真正的工程挑战,在于这些不同速度的系统怎样正确交流。
最关键的指标之一,是当真实世界已经偏离模型预测时,机器人多久才能发现,并以足够可靠的动作作出反应。
AI 需要的不是更高清的眼睛,而是神经末梢
机器人夹起一颗鸡蛋。视觉可以判断鸡蛋在哪里,也能估计外形与姿态,但摄像头不一定看得见被手指遮挡的接触面。开始夹取时最先变化的,往往不是图像里的位置,而是接触力、局部形变和微小滑移。
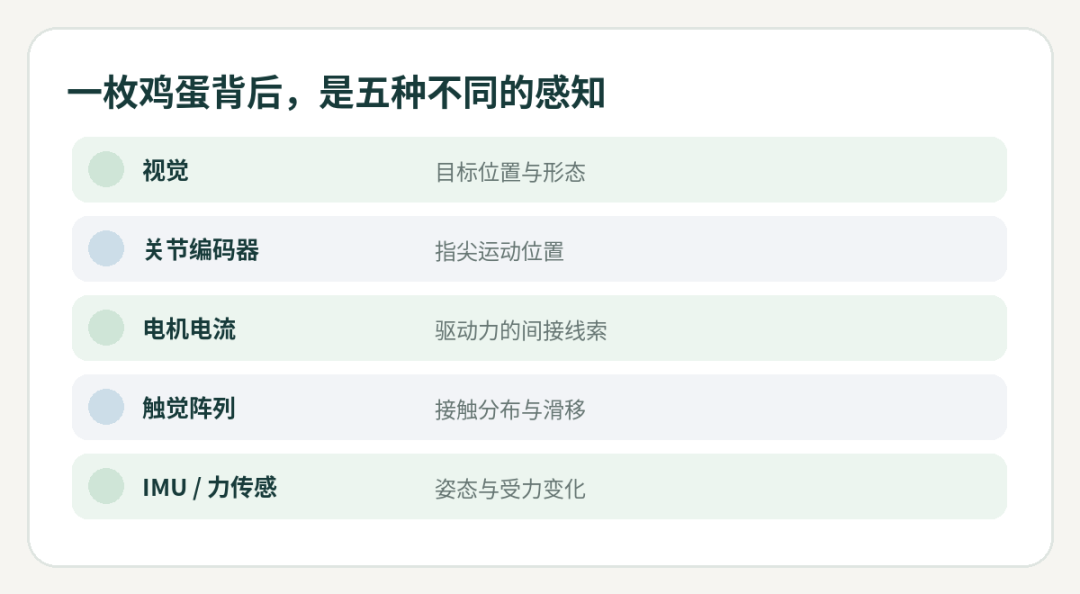
同样,关节编码器能告诉系统轴的位置和变化,电机电流可以间接反映驱动负载,但电流还受电机参数、摩擦和传动机构影响,不能直接等同于指尖接触力。触觉阵列可以提供局部接触的空间信息,IMU 则擅长捕捉运动、姿态与振动。多传感器融合的价值,就在于利用互补信息减少盲区。
但电子皮肤也会制造新的麻烦:数据洪水。假设1000个触觉单元,每单元16位,采样率1 kHz,纯有效载荷达到16 Mbit/s。若增加到1万个单元,便是160 Mbit/s。这里还没有加入地址、时间戳、诊断、协议以及多模态数据。
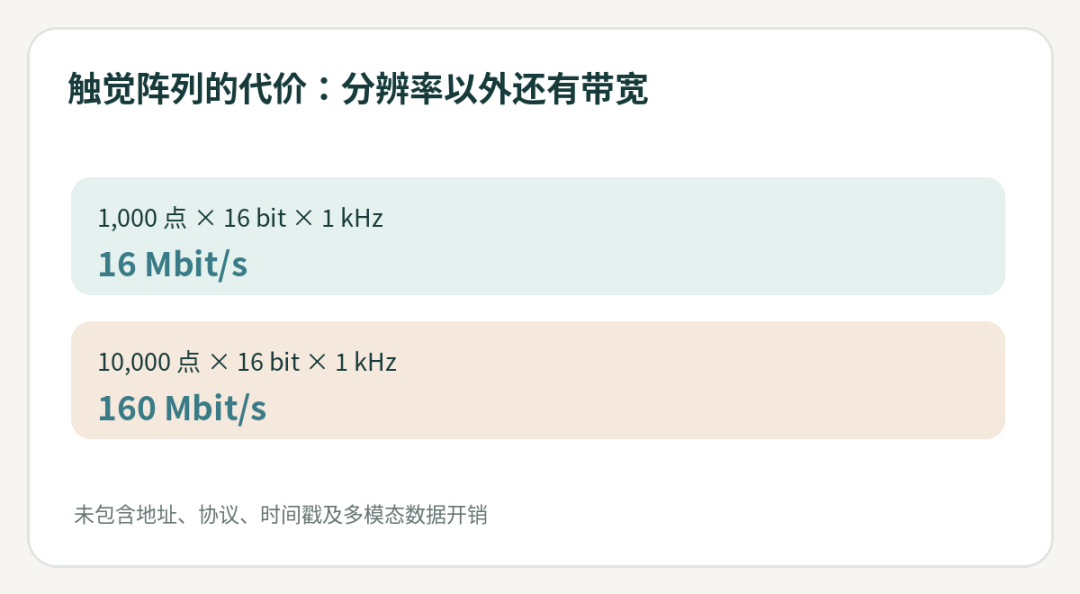
因此未来值得关注的并非只有更高的触觉像素密度,还包括传感器端事件检测、稀疏编码、边缘特征提取和滑移判别。高层 AI 可能根本不需要看到每个像素的每个原始数值,它真正急需的是“右手食指刚发生滑移,立即调整夹持力”这样可靠且低延迟的状态事件。
一颗16位编码器,真的就足够精确吗?
拿最常见的旋转编码器举例。16位单圈绝对值角度意味着每圈 65,536 个量化位置,理论角度步距约 0.00549°。这是一个特别容易被宣传文案偷换的数字:它仅代表分辨率,不代表系统在所有温度、转速和安装状态下的角度准确度。
量化步距 = 360° ÷ 65,536 ≈ 0.00549°
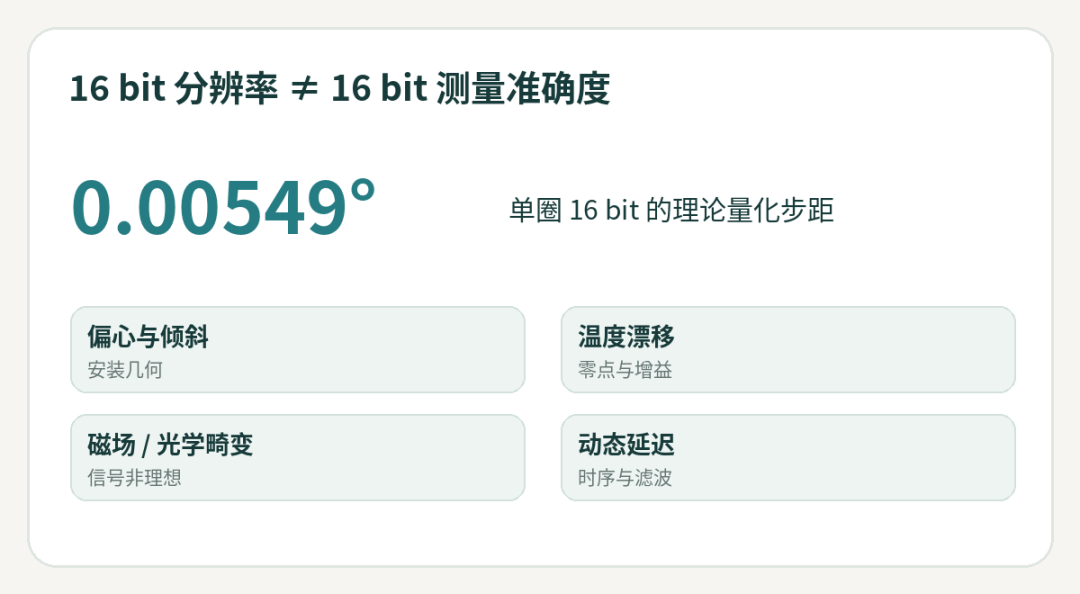
离轴或轴端磁编码器要面对安装偏心、磁铁倾斜、磁场幅值不均匀、温漂和谐波畸变;光学编码器要面对码盘质量、污染、光源老化、信号幅值和机械装配误差。高分辨率本身无法使这些误差消失。
尤其在机器人关节中,温度并非始终保持25°C,电机本体还有持续振动和电磁干扰。更复杂的场景还会出现时间同步错误:控制器以为读到的是“此刻的位置”,实际上那可能是几十或几百微秒前的状态。
这时,传感器系统不应只输出漂亮的角度数字,还应该输出足够清晰的诊断信息:磁场强度是否可信、幅度是否低于阈值、内部校准是否有效、数据何时采样、通信是否发生异常。真正好的状态估计,不是绝不出错,而是在出错时能够准确评估自己还有多大把握。
世界模型最危险的瞬间,是它过分相信自己
物理 AI 热门方向之一是世界模型(World Model):不仅识别当前环境,还预测“如果我这样动作,下一刻会发生什么”。这对长序列任务非常重要。机器人必须根据摩擦、接触、惯性和几何关系,推测将要发生的结果。
问题在于,预测总有失效的时候。机器人认为桌上的纸箱会在某个推力下向前移动20厘米,实际箱底可能粘着一条胶带;它认为关节没有外力扰动,实际轴承却已出现卡滞。若模型持续相信自身预测,就可能把误差越推越大。
预测状态 + 测量残差 × 校正增益 → 更新后的状态估计
在状态估计的基本思想里,“预测结果”和“传感器真正测得的结果”必须彼此校验。创新量(innovation)或测量残差正是这种偏差的表达。残差持续变大,可能代表外界发生了变化,也可能是传感器故障、模型偏差或时间戳错误。无论哪一种,系统都应调查,而不是习惯性忽略。
一个成熟的物理 AI 系统,必须同时有勇气做预测,也有机制承认预测失败。
下一个 AI 半导体机会,可能不长得像 GPU
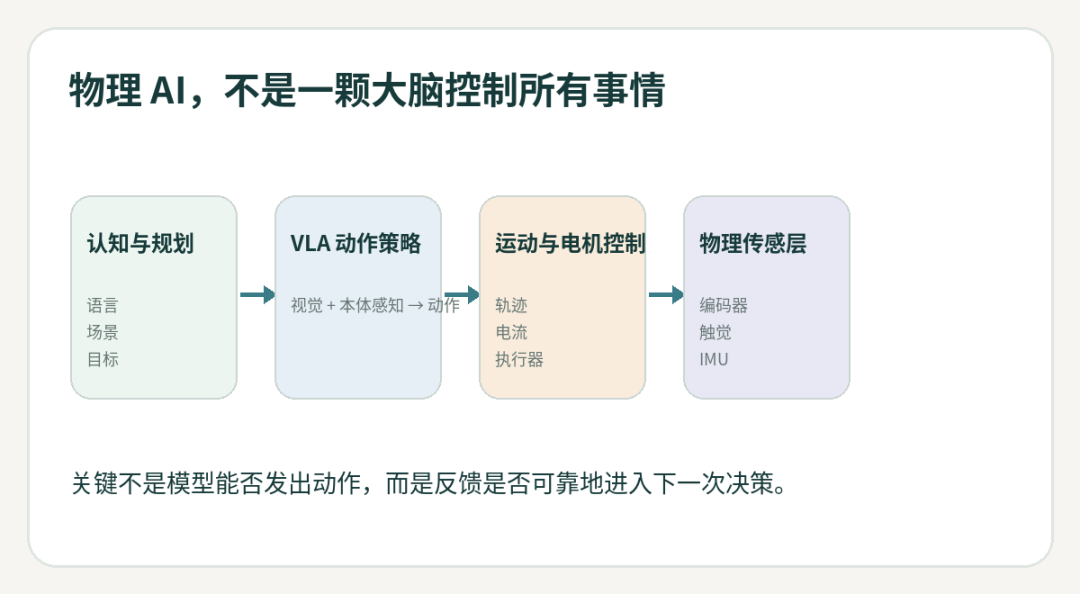
过去几年,算力和模型吸走了绝大多数注意力。可机器人进入工厂、医院与家庭后,系统在每一层都会遇到不同的半导体需求:高层需要可扩展算力与存储;中层需要低功耗边缘推理;底层需要高可靠传感、实时控制、电机驱动和安全监测。
一颗先进触觉ASIC,可能更重要的不是能运行多少参数的神经网络,而是能不能稳定读出微小接触变化,抑制噪声,在极短延迟内报告滑移。对于角度编码器,则可能要同时兼顾全温准确度、速度响应、通信可靠性和自诊断。
这也意味着,未来的传感器厂商只谈“多少位分辨率、多少MHz通信频率”,可能已经不够了。真正有说服力的价值主张是:装上芯片后,机械臂的抓取成功率、接触检测误报率、温漂下的定位一致性或系统校准时间是否真的改善。
当然,具身智能并不自动保证传感器厂商都能赚钱。主机厂自研、芯片标准化和价格竞争仍会持续。只有真正影响系统级性能、可量化降低客户总成本的传感器,才更有机会得到溢价。
最后:人工智能的下半场,不是把话说得更漂亮
一个孩子学会抓住水杯,是因为他的手持续感知杯子的重量、摩擦和滑移。没有人在每一次动作前都写完一篇关于牛顿定律的论文。智能不仅是知道规则,更是把规则变成及时的身体反应。
今天的 AI 已经能够解释控制理论、写复杂代码、分析机器人操作录像。这些能力很了不起。但真实世界并不会因为模型的答案富有逻辑,就允许机械系统跳过测量、控制和安全验证。
人工智能的上半场,是让机器越来越会回答。下半场,是让机器真正知道:现实什么时候不同意它。
届时,一颗编码器、一片电子皮肤、一枚惯性传感器,或许不再只是整机BOM表上不起眼的器件。它们将成为人工智能连接现实世界的神经末梢。
关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。