『M序列编码器』这个名词能存在,就是这个行业的『耻辱”』
首发于公众号「如是有为」 · 查看原文
一、这句行话,听着顺耳,看着丢人
编码器圈子里,有一句话被说得太顺了,顺到很多人已经不觉得它有问题:“我们这是m序列编码器。”
这句话最恶心的地方,不是它完全胡说,而是它只对了一小半,却偏偏摆出一副全都说清了的样子。前面先端出几个很唬人的词:本原多项式、LFSR、最大长度、伪随机。气势一下就起来了。可你真往下追,多项式哪来的,怎么证明它真是本原多项式,为什么它滚出来的那串东西就能直接变成绝对编码器码盘,很多材料就不再展开了。最后,所有没讲明白的地方,都被一句特别顺嘴的话糊过去了:m序列编码器。公开产品资料和公开专利里,确实都能看到把单轨绝对图样叫成 “M-sequence pattern” 或 “shift register code” 的写法;问题不在于没人这么叫,问题在于这个叫法本身,已经把几件不同的事硬挤成了一件。
说得再难听一点,这就像把加了涡轮、改了电控、换了传动、最后勉强跑得很快的奥拓,硬叫成“特斯拉”。奥拓当然可以改,改完也可能真能跑,这不丢人。丢人的是,真正让它能跑起来的,是后面那一大堆改装;可这些改装你一句不提,反而抓着最开始那台奥拓不放,逢人就说自己开的就是特斯拉。很多“m序列编码器”的说法,味道就是这个味道:前面拿一个听起来很高级的旧名词镇场,后面真正让东西可用的那些脏活累活,却被一句行话抹平了。
二、真m序列到底是什么,这件事先别装糊涂
真m序列并不神秘,但它也绝不是“看起来有点乱的一串0和1”。
正规定义很硬。它是LFSR在本原多项式驱动下产生的最大长度序列。Cambridge 的《Algebraic Shift Register Sequences》直接说,m-sequence 本质上是一个punctured de Bruijn sequence,也就是“挖掉了一个状态的de Bruijn”;同一本书和 Springer 的相关条目都明确指出,它的周期是“2的n次方减1”,不是“2的n次方”。翻成人话就是:真m序列最关键的特征,不是高级,而是它天生少一个状态。缺的那个,正是全零状态。(文件链接 https://assets.cambridge.org/97811070/14992/excerpt/9781107014992_excerpt.pdf)
这件事特别重要,因为很多行业材料恰恰在这里故意糊弄。假设一次读取n位,那么本来一共有“2的n次方”种n位状态。真m序列不是把这“2的n次方”种都覆盖,而是把其中所有非零状态都跑一遍,唯独把全零丢掉。也就是说,真m序列解决的问题是:怎样用LFSR和本原多项式,得到一条遍历所有非零状态的最大长度序列。它解决的不是:怎样让绝对编码器整圈上所有用于定位的窗口都恰好可用。这两件事有联系,但压根不是一回事。
更尴尬的是,很多人连这套话最起码的前提都不肯说全。因为LFSR要跑成最大长度,不是你随手写个反馈多项式就行,关键前提是这个多项式必须是 primitive。公开教材和工程资料说得很明白:m-sequence 的定义本身就绑着 primitive polynomial 和“遍历所有非零状态”这两个条件。换句话说,如果你手上没有本原多项式表,没有本原性判定能力,也没有说明自己到底选了哪个多项式,那“按m序列方法设计编码器”很多时候更像是在摆姿势,不像在讲流程。
三、绝对编码器真正要的,是“窗口唯一”,不是M序列的“最大长度”
绝对值编码器真正关心的,核心其实只有一句:读头眼前这一小段码,必须唯一对应一个位置。
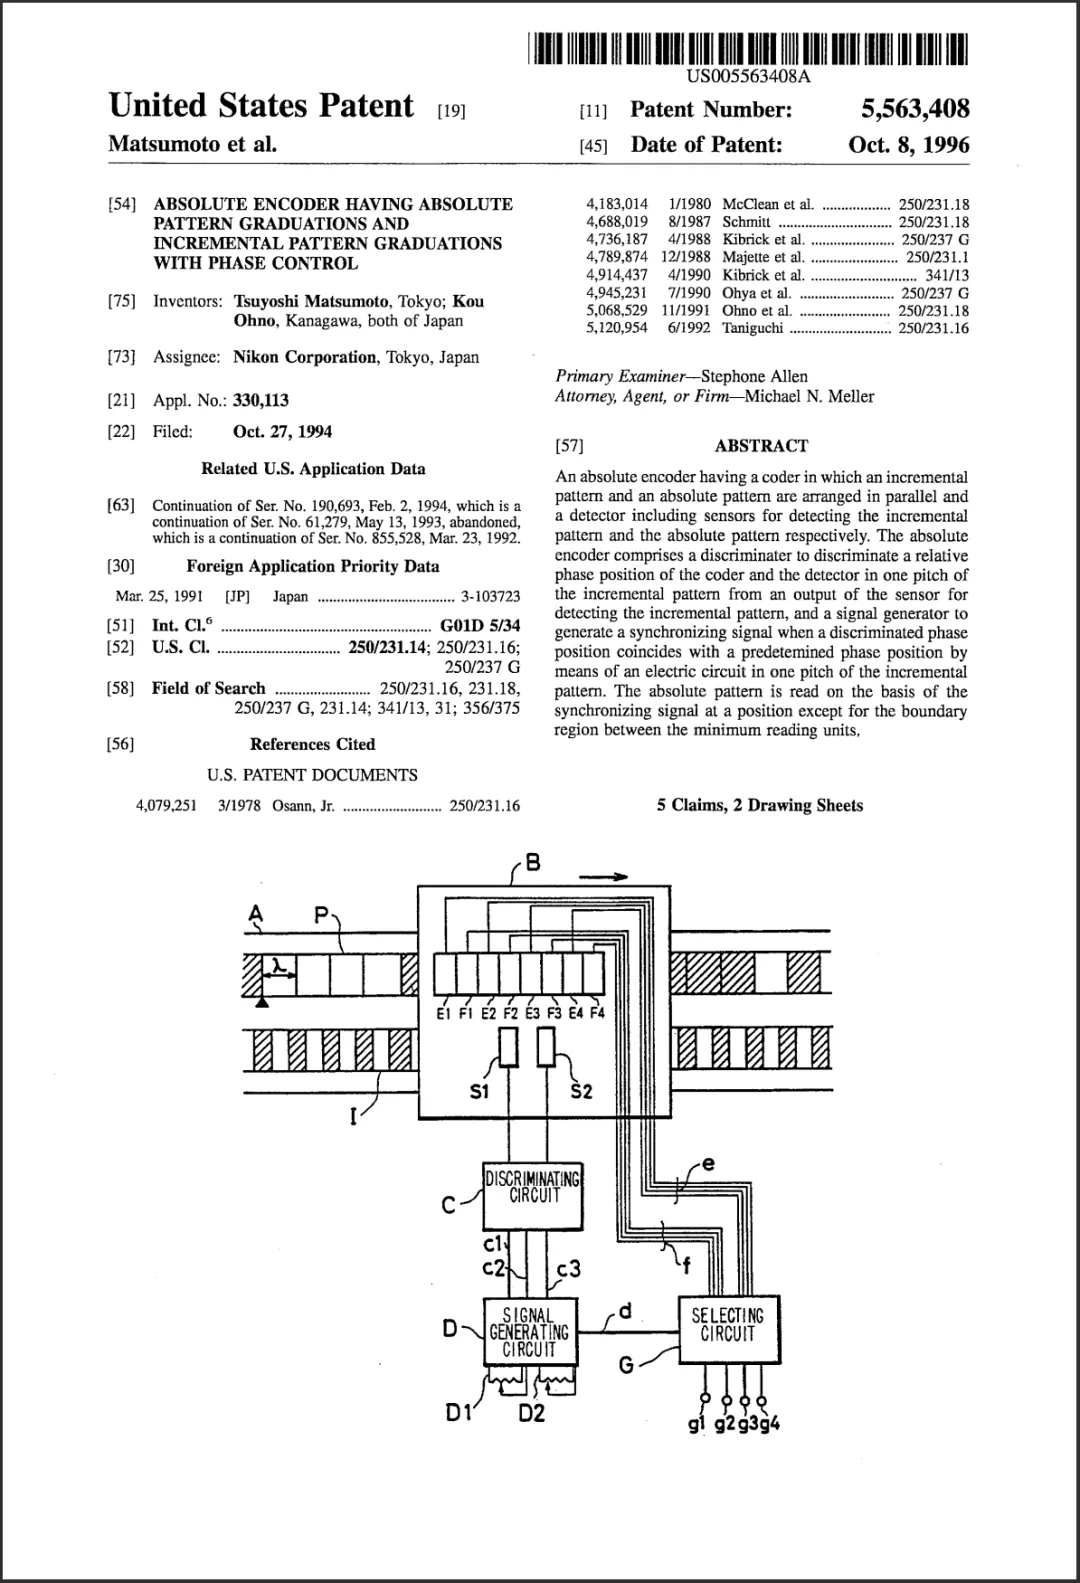
这不是我在抬杠,早期单轨绝对编码专利就是这么写的。US4947166A 明确说,对于N位码,每N个相邻bit必须代表一个唯一的N位字;US5563408A 也在单轨绝对图样的上下文里,用具体序列来说明如何通过连续读取窗口得到位置相关信息。只要把这件事抓住,很多行业里云山雾罩的话,其实一下就散了。因为你马上就能看出来:绝对编码器真正的数学要求,是连续窗口唯一定位,不是“先找一个听起来很像数学的名字”。
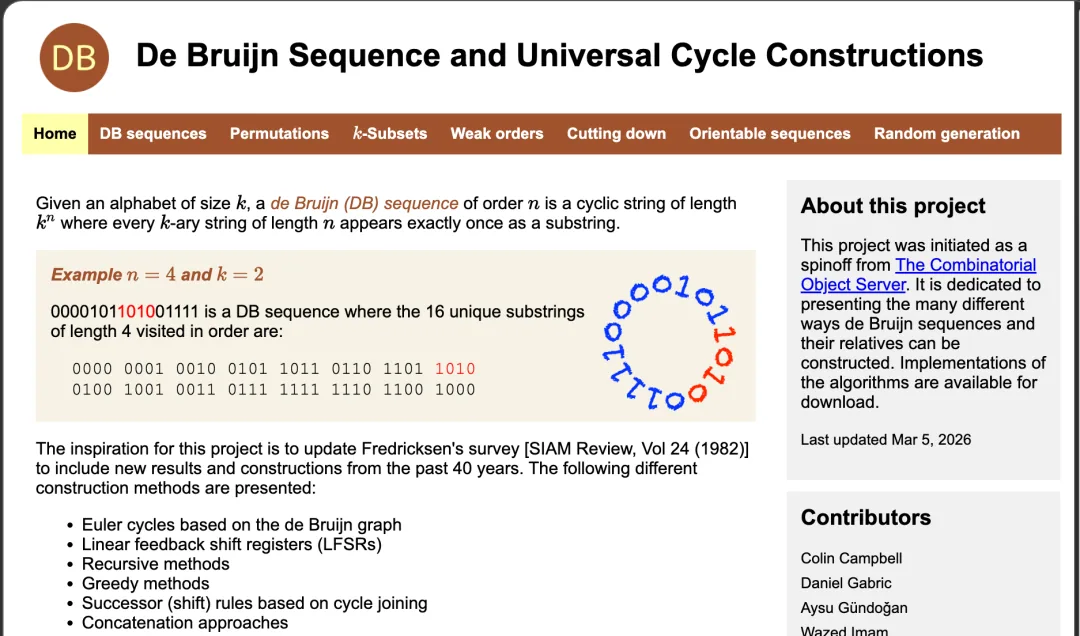
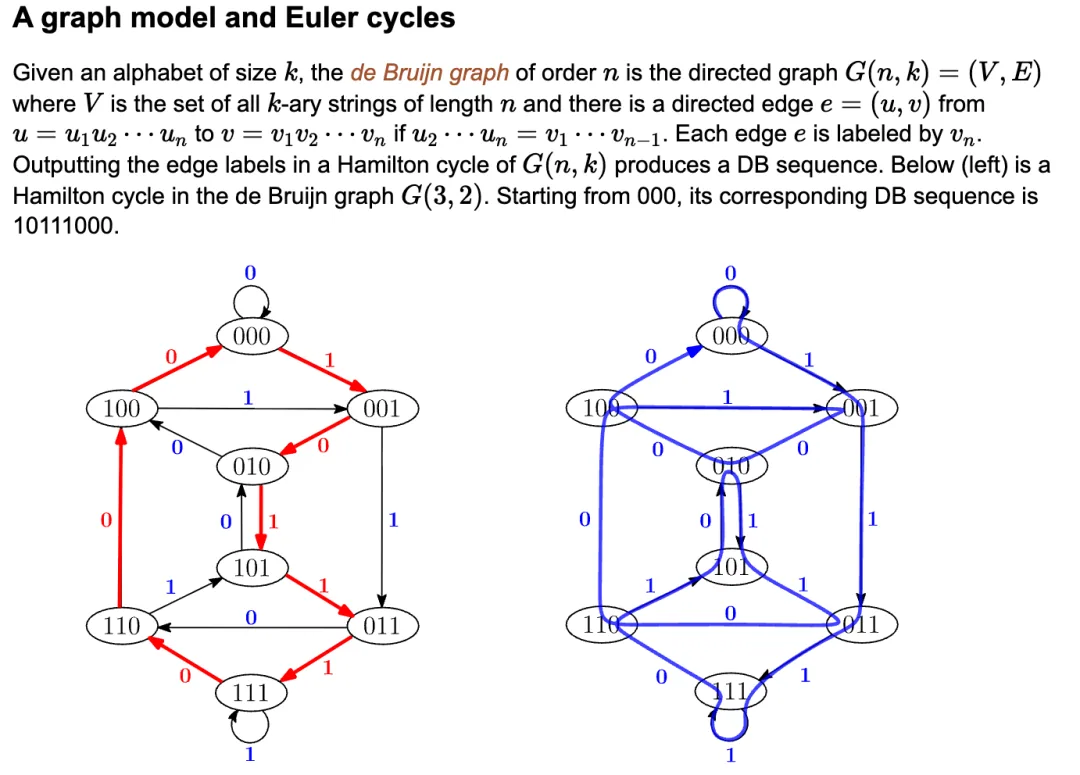
顺着这个要求往下走,真正正对题面的对象,其实是de Bruijn 序列。debruijnsequence.org 对它的定义很直接:长度为n的所有字符串,在一个循环序列里都恰好出现一次。
更重要的是,它给出的构造路线本来就很多:图方法与Euler环、LFSR、递归、贪心、cycle joining、拼接都可以;在图方法那一页,它甚至直接写到,所有二元de Bruijn序列都可以通过考虑所有可能的 spanning in-trees 来生成。换句话说,de Bruijn 回答的是“如何得到一个所有窗口都唯一出现一次的循环码”;它当然可以和LFSR发生关系,但它绝不等于“本原多项式那一套话”。
这也就解释了一个很多人嘴上轻飘飘带过、实际上却极要命的问题:补一个零,不等于事情就结束了。
原始真m序列天生少一个全零状态。可绝对编码器要的是窗口唯一,而不是“数量看起来差不多”。你随便补一个状态,窗口就可能重复;窗口一重复,读头眼前同一段码就可能对应两个位置,那这东西就不叫绝对编码了。问题根本不是“缺没缺一个零”,而是“整圈窗口是不是恰好唯一”。这一层,真正回答问题的仍然是 de Bruijn 那套逻辑,不是你把“本原多项式”多念几遍就自动搞定。
四、真正从零做单轨绝对编码,根本不是一句“按m序列方法”就能打发的
这一点,其实有公开论文把话说得非常明白。
2009年一篇专门讨论单轨轴编码器序列设计的论文,在一开始就把问题挑破了:要做单轨编码器,本质上是要找到一条长度为e的循环序列,使得由连续n个符号组成的所有子字都彼此不同。紧接着作者马上承认:这个问题一般来说并不容易;虽然这些序列总是存在,但对任意给定的q和e,并没有已知的高效算法来找到其中一条。只有在一个很特殊的情形下,也就是当 e 等于 q的n次方减1,且 q 是素数幂时,最大LFSR序列才已知能生成这样的序列。作者后面做的事,也不是一句“本原多项式”就完了,而是给出一个面向更一般情形的算法,甚至在结论里明确写到:它呈现的是一套穷举搜索式的算法,用来设计任意期望分辨率的单轨编码器。
这段话的杀伤力很大,因为它正好戳穿了很多行业里的表演。
很多人说“我们按m序列方法设计绝对编码器”,那口气听起来像什么?像是只要会背“本原多项式+LFSR+最大长度”这几个词,后面的一切就自然而然地成立了。可真正做过这件事的人,公开论文自己都告诉你了:不是这样的。真正的问题一般并不容易;LFSR只是在一个特定长度家族里才是现成答案;走到更一般的长度、更一般的传感器配置、更一般的工程约束时,你面对的是构造、筛选、搜索、验证,而不是一句顺口溜。
这也就是为什么,从绝对编码器的角度看,老老实实说“我是围绕窗口唯一去找候选,再筛出一个可用解”,一点都不丢人。相反,这才是正经路子。
你可以用de Bruijn图去找Euler环,可以用spanning in-tree去生成所有二元de Bruijn序列,也可以在特定规模上做枚举、回溯、搜索。公开文献里甚至直接写到,他们对小规模de Bruijn序列做了穷举生成,并且使用了backtracking方法。
也就是说,围绕“窗口唯一”去穷举、去搜索、去筛选,本来就是这类问题的正经方法之一。丢人的从来不是“筛出来”,丢人的是明明靠筛、靠试、靠改、靠验证才得到可用解,最后却把整个成品按“m序列”三个字一把打包。
五、公开专利自己都承认:原始m序列不够,最后还得改、还得算、还得查
最打脸的地方,不用靠猜,公开专利自己就写出来了。
CN103557878A 一边把这类编码叫作“M序列伪随机码”的绝对编码,一边又非常老实地写出“扩码方式多码道伪随机码”“扩码方式p元M序列伪随机码”。这已经把话说得很明白了:真正拿去做直线绝对位置编码器、圆盘绝对角度编码器的,不是一个原封不动的“真m序列”,而是经过扩码之后的工程成品。既然连专利自己都承认要扩码,行业里还老喜欢一口咬死“m序列编码器”,那就不是技术严谨了,那是嘴上图省事。
CN107314780A 也一样。它一边讲“对于使用LFSR编码的光学尺,在解码端也可以利用LFSR来还原编码顺序”,一边又老老实实承认:真正的解码装置里还要有线性反馈移位暂存器、查表电路、计数器、计算电路,而且查表结果值的种类满足 “k 小于等于 2的n次方减1”。这是什么意思?意思就是,真正能工作的东西,本来就不是一句“LFSR生成m序列”能包掉的。后面还有查表、混合解码、计数、计算这些一地鸡毛。谁拿一句“m序列编码器”把这些全抹平,谁就是在拿口号遮细节。
CN112947895B 再往前走了一步,它直接把“基于本原多项式获得伪随机序列和多个冗余位,再基于本原多项式获得预测位,之后对冗余位和预测位进行比对,并在必要时利用预设结果对照表定位错误位”的整套流程写出来了。这里已经不是“我有一条m序列”这么简单了,而是伪随机序列、冗余、预测、比对、查表纠错一起上。也就是说,到了工程现场,大家都知道后面还得缝缝补补、加校验、做容错。可嘴上却还是喜欢把整个成品一口叫成“m序列编码器”。这不是不会做事,这是懒得把事说清楚。
六、最难看的地方,是很多东西根本就是抄来的,连错误的解释都是一代代抄下来的
这件事最难看的地方,不是“名字起错了”,而是很多名字、很多序列、很多说法,本来就是照着前人的公开结果一路抄下来的,抄到最后,连自己都信了。
先说公开能坐实的部分。1996年的 US5563408A,已经把单轨绝对图样里使用的一个15位 M-sequence 例子公开摆出来了:000100110101111。它不是只讲原理,而是直接把具体序列写出来,说明怎样把0和1替换成不同读出单元来构成单轨绝对图样。这意味着什么?意味着至少在公开层面,行业里很多“单轨M序列图样”的基本样板,三十年前就已经亮给所有人看了。
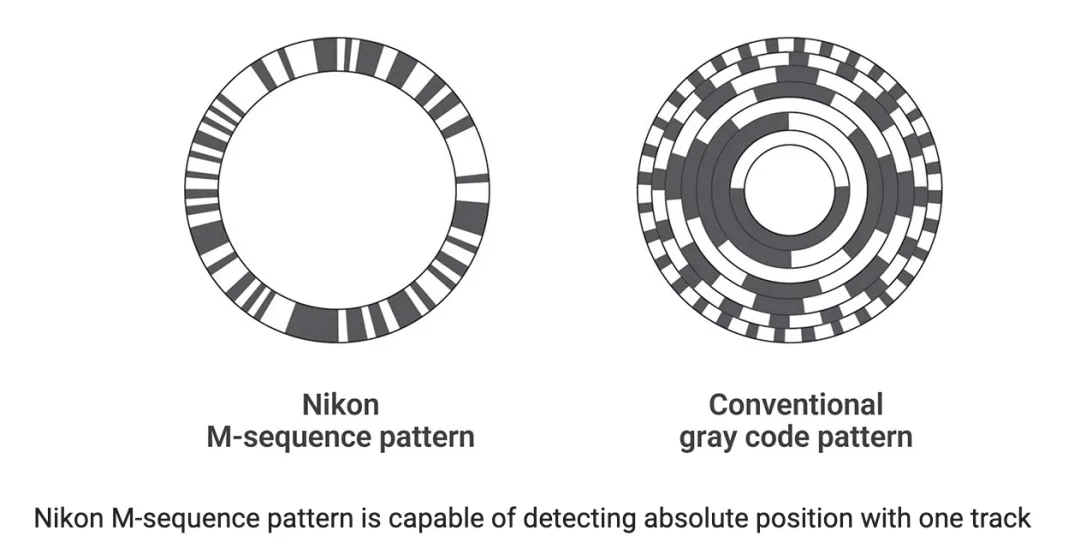
再往后看,产品宣传把这层口径继续固化。Nikon 长期公开使用 “M-sequence one-track absolute pattern” 这个名字,并强调“单轨就能生成绝对值数据”“上电立即输出全绝对数据”“尺寸更小、可靠性更高”。产品这么叫,专利这么叫,培训材料再照着抄,最后 “m序列编码器” 四个字就越来越像行业口头禅。问题是,产品口径不是数学定义,宣传名词也不是严格分类。一个名字在市场里好用,不等于它在技术上就完全干净。
再看论文和专利侧,路数其实也很像。前面先把LFSR、本原多项式、最大长度这些老词端出来,后面再补扩码、查表、冗余、纠错、混合解码,最后对外一口叫成“m序列编码器”或者“m序列绝对码”。很多文本真正重复的,不是“从零构造序列的过程”,而是“前人那套话术模板”:LFSR可以产生MLS,MLS可用于单轨绝对图样,后面再用查表或冗余做解码和纠错。你要说这里面一点工程含量都没有,那也不公平;但你要说这就是“自己从零搞懂并独立产生了一套绝对编码序列”,那就更不老实了。公开论文自己都承认,一般情形下这个问题并不容易,LFSR只在特殊长度家族里是现成答案,更一般的情况需要额外算法,甚至穷举搜索。可很多后来文本给人的感觉,却像是只要会背“本原多项式+LFSR+M序列”这几个词,自己就已经掌握了完整的序列设计方法。
这就是最让人反胃的地方。
不是复用公开结果丢人。工业界复用成熟结果,太正常了。
不是借老序列当毛坯丢人。很多工程路线本来就是从毛坯改出来的。
真正丢人的是:明明自己抄的;可嘴上却非要摆出一种“我们从数学源头上就已经彻底搞懂了”的架势; 而解释的那套东西根本是错的。
更丢人的是,很多人连这套错话为什么错都没认真核对过。前人这么写,他就这么写;前人把扩码后的成品叫M序列,他也跟着叫;前人把“特殊情形下LFSR可用”讲成“通用方法”,他也照着抄。抄序列,抄话术,抄历史口径,抄到最后,竟然抄成了“行业共识”。这不是正常的知识传播,这是把偷懒一代代标准化。
所以标题里的“耻辱”两个字,不是故意摆情绪,而是这件事确实配得上这两个字。因为一个正常的行业,至少应该分得清这几件事:
真m序列是什么。
绝对编码器真正要的是什么。
de Bruijn为什么才是“窗口唯一”这道题的正面答案。
LFSR和本原多项式为什么只是某些特殊情形下的一条路,不是万能咒语。
复用公开结果不丢人,但拿复用冒充原创,拿错名冒充分类,才丢人。
可现在很多场合里,这几件事偏偏被压扁成了一句最省事的话:m序列编码器。
一句话总结:
真m序列,是“LFSR在本原多项式驱动下跑完所有非零状态”的那个数学对象;绝对编码器真正要的,是“连续窗口唯一定位”的那个结构。前者可以是后者的一块毛坯,但绝不是后者的名字。把不是m序列本体的绝对编码,硬叫成“m序列编码器”,再把这种错话一代代抄成行业共识,这不是什么行业习惯,这是这个行业自己的耻辱。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。