编码器公司用AI写芯片只要30秒,标定判断却越来越贵
首发于公众号「如是有为」 · 查看原文
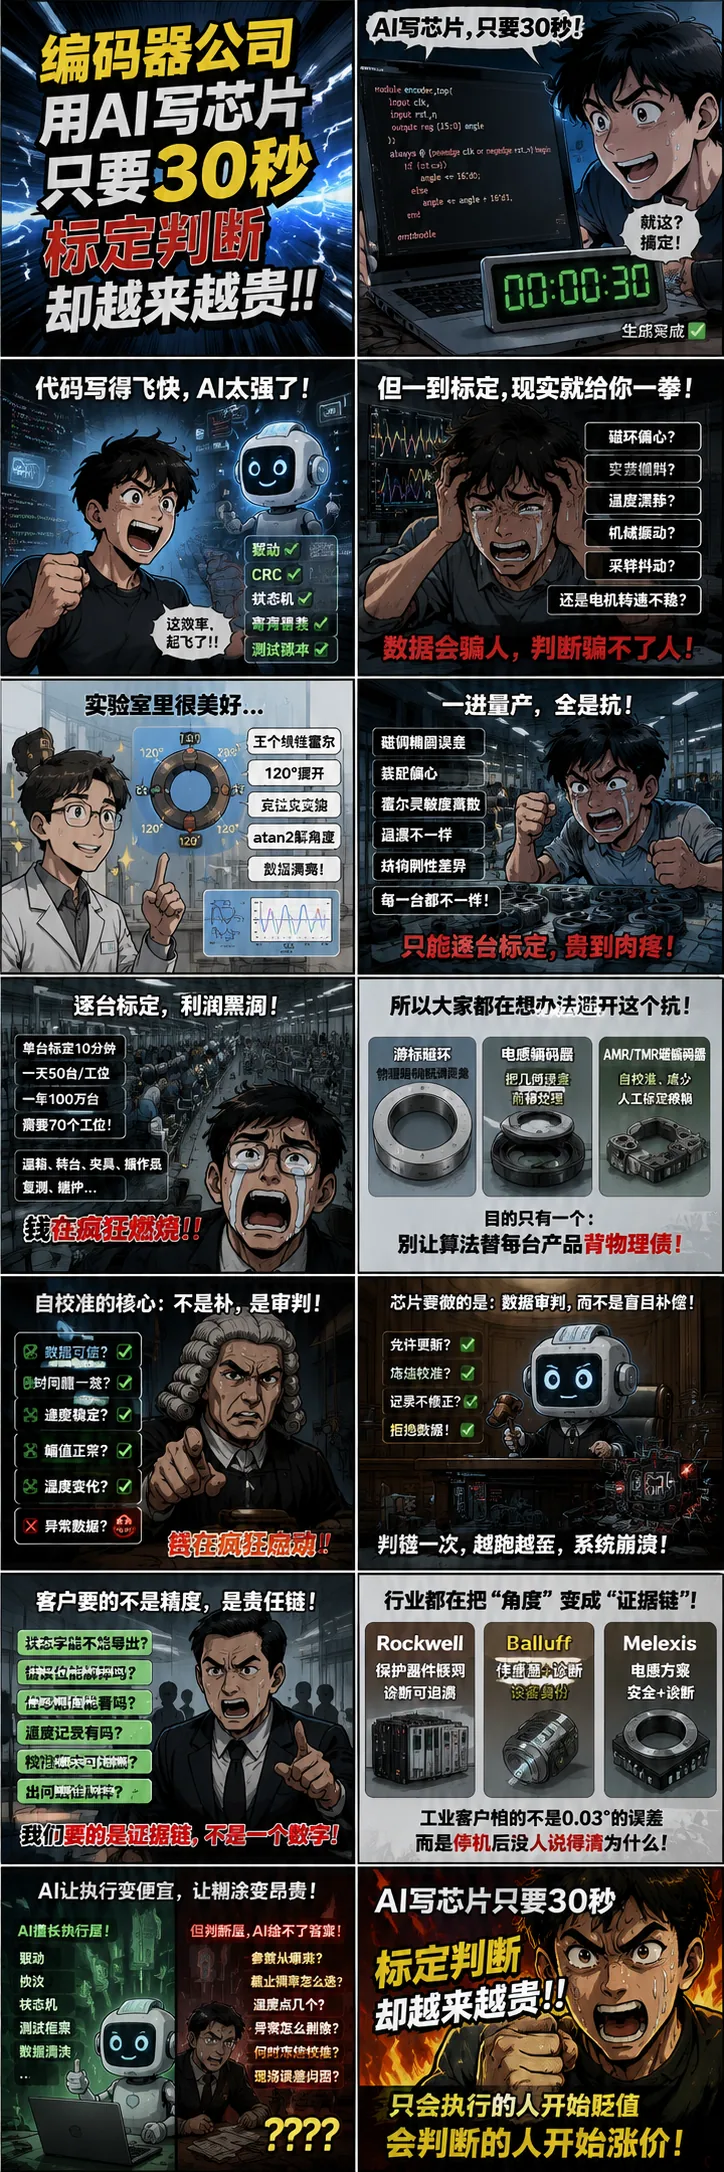
2026年,很多工程师已经习惯了这种工作方式:写一段 SPI 驱动,丢给 AI;补一个 CRC 校验,丢给 AI;搭一个状态机框架,丢给 AI;甚至 Verilog 模块骨架、寄存器映射表、测试脚本,AI 几十秒就能吐出来。很多人看到这个,会自然得出一个判断:芯片开发的人力要贬值了。
但如果你真做过编码器芯片,就会知道,贵的从来不是“把代码敲出来”这件事。贵的是判断,尤其是标定判断。
AI会写代码,但它不知道哪段数据该相信
GitHub Copilot 已经开始把账单从“包月幻觉”往真实使用成本拉。Business 套餐本身没直接翻倍,但重度 agent 使用开始按 AI Credits 和 token 消耗计费。Claude 也是一样,轻度用还是那个价格,真拿来高强度干活,成本马上变成另一回事。
这事看着和编码器没关系,其实是一回事。AI 把执行层的成本快速打下来了,但判断层反而更值钱了。编码器标定就是最典型的例子。
AI 可以帮你写拟合程序、滤波器、LUT 更新逻辑,甚至帮你把整套校准框架代码搭起来。但 AI 不知道这段数据到底该不该进校准表。因为现场数据从来不是数学题。它可能是磁环偏心,可能是安装倾斜,可能是联轴器热变形,可能是机械负载振动,可能是采样时序抖动,也可能只是电机那一刻转速不稳。AI 看到的是波形,工程师看到的是因果链,差别就在这里。
真正吃利润的,从来不是算法,是逐台标定
实验室里很多方案都很好看。三个线性霍尔,120° 摆开,做克拉克变换,再 atan2 解角度,论文里数据很漂亮。可一进量产,事情马上变味,因为每一台机器都不一样。
磁钢可能有椭圆误差,装配可能有偏心,霍尔灵敏度有离散,温漂不一样,机械结构刚性也不一样。于是你就只能逐台标。
假设一个保守量产模型:单台标定 10 分钟,一个工位一天 50 台,一年 100 万台。算下来,大概要 70 个工位。温箱、转台、夹具、操作员、复测、设备维护,钱不是一点点烧掉,是持续吞利润。
所以很多编码器架构,本质上都在绕这个坑。游标磁环想办法把误差在物理结构里抵消,电感编码器尽量把几何误差前移处理,AMR/TMR 磁编码器拼命做自校准。目的就一个:别让算法替每一台产品背全部物理债,因为那太贵了。
昆泰芯这类自校准,本质是在做“数据审判”
很多人看自校准,会觉得:哦,就是自动补误差。太浅了。真正值钱的,不是补,是判断能不能补。
比如昆泰芯 CN117168530B 这种路线,本质不是简单存一张补偿表。核心问题是:哪些数据可信?哪些数据不可信?什么时候允许更新?什么时候冻结?什么时候只记录,不修正?这不是“自动校准”,这是“自动审判”。
芯片要判断这次经过参考点是不是稳定,时间戳是不是一致,速度是不是乱跳,信号幅值是不是异常,温度变化是不是太快。如果判断错了,就会把错误数据写进校准表,然后系统越跑越歪。这事 AI 最容易干,因为 AI 最喜欢“看起来合理”,但工程系统最怕“看起来合理”。真正的编码器工程师知道,有些数据必须拒绝。
工业客户买的已经不是精度,是责任链
很多编码器公司还在卷 21 位、22 位、24 位,更高分辨率,更低 INL。客户当然看这些,但越来越多客户先问的是别的:状态字能不能导出来?错误位能不能解释?信号幅值能不能看?温度记录有没有?校准版本能不能追溯?现场出问题谁解释?
这个变化很明显。Rockwell 把控制柜里的保护器件往网络里接,Balluff 的传感器把诊断和设备身份一起打包,Melexis 的新电感方案也拼命强调安全和诊断能力。大家都在做同一件事:把一个数值,变成一条证据链。
因为工业客户真正怕的,不是角度差 0.03°,而是设备停了以后,没人说得清为什么。编码器行业也一样,过去卖的是角度,现在卖的是可解释性。
AI让执行变便宜,让糊涂变昂贵
AI 最适合干执行层:SPI 驱动、CRC、状态机、寄存器配置、通信协议、测试框架、数据清洗,这些都适合。但参数从哪来?截止频率怎么选?载波频率为什么是这个?温度点几个?角度点几个?异常怎么剔除?什么时候冻结校准?客户现场误差怎么归因?这些东西,AI 给不出真正答案。
因为这些答案不在公开训练数据里。它在你现场,在客户那台疯跑的电机上,在那条偶发的异常波形里,在那个只有特定温度、特定负载、特定转速才出现的问题里。
所以真正的变化不是 AI 让芯片工程师不值钱了。真正的变化是:只会执行的人开始贬值,会判断的人开始涨价。
编码器公司用 AI 写芯片只要 30 秒,标定判断却越来越贵。

关注公众号「如是有为」
微信扫一扫,新文章先在公众号发出。